生存分析:Kaplan-Meier 与 Cox 回归
生存分析研究「从起点到某事件发生需要多长时间」,事件可以是死亡、复发、进展或任何终点。它的核心是正确处理删失:随访结束时仍未发生事件或中途失访的个体,只知道其生存时间至少有多长。Kaplan-Meier 法描述各组随时间的生存概率,Log-rank 检验比较曲线差异,Cox 比例风险回归在校正年龄、分期等协变量后估计风险比(HR)。在生物医学研究中,它常用于评估基因表达、突变或评分与患者预后的关系,数据来自临床随访或 TCGA 等公共队列。
什么时候用
- 比较不同治疗组、亚型或基因分组的生存差异
- 评估某基因表达或评分是否与总生存、无进展生存相关
- 判断某因素在校正临床变量后是否为独立预后因素
- 估计中位生存时间和特定时间点的生存率
- 存在多种互斥终点时评估累积发生率
- 为预后模型构建做单因素候选变量筛选
不适合的情况
- 事件数很少却要纳入很多协变量做多因素 Cox
- 只关心是否发生事件而随访时间不可用,此时用逻辑回归
- 暴露在随访后才发生时直接按最终状态分组
需要准备的数据
- 生存时间
- 从统一起点(诊断、手术或入组)到事件或最后随访的时间,全表使用同一单位
- 事件状态
- 通常 1 表示发生事件,0 表示删失;需写清是哪种终点,如 OS、PFS 或 DFS
- 分组或连续变量
- 基因表达、突变状态、评分或治疗分组;连续变量需说明是否分组以及分组方式
- 协变量
- 年龄、性别、分期、治疗等需要校正的临床变量;检查缺失比例和分类水平的样本数
分析步骤
- 1
定义终点与起点
先确定事件类型和时间起点,例如 OS 从诊断到任何原因死亡。核对每个样本的时间是否为正数、状态编码是否一致,并统计事件数和中位随访时间。
- 2
整理变量与分组
连续变量可直接进入 Cox,也可按中位数或预设阈值分组用于画图。分类变量要设定参照组,样本极少的水平应合并,否则 HR 估计不稳定。
- 3
绘制 KM 曲线
用 R 包 survival 的 survfit 估计生存函数,survminer 的 ggsurvplot 绘图,附风险人数表和删失标记。读出各组中位生存时间及其置信区间。
- 4
Log-rank 检验
用 survdiff 比较组间生存曲线。Log-rank 对整个随访期的差异都敏感,但在曲线交叉时检验力会下降,此时需要结合图形和其他方法判断。
- 5
单因素 Cox 回归
用 coxph 对每个变量单独拟合,得到 HR、95% 置信区间和 P 值。连续变量的 HR 对应每增加一个单位的风险变化,需要注明单位或是否标准化。
- 6
多因素 Cox 回归
把目标变量与临床协变量一起纳入模型,判断其是否为独立预后因素。变量数应与事件数相匹配,常用经验是每个变量至少约 10 个事件,超出时需减少变量或合并类别。
- 7
检验比例风险假设
用 cox.zph 基于 Schoenfeld 残差检验每个变量和整体模型。若某变量 P 值显著或残差图随时间有明显趋势,说明 HR 随时间变化,需要分层或加入时间交互项。
关键参数与决策
终点选择
OS 定义清楚但受其他死因影响,PFS 和 DFS 事件更多、所需随访更短,但依赖评估时间点。随访短或死亡事件少时,优先用事件更多的终点。
连续变量分组方式
中位数分组最常用;预设的临床阈值更有说服力;数据驱动的最佳切点会使 P 值偏小。条件允许时同时报告连续变量的 Cox 结果。
协变量的纳入
根据临床知识预先确定需要校正的变量,而不是只纳入单因素显著的变量。分期等变量缺失较多时,需说明处理方式,如完整病例分析或多重插补。
竞争风险
关注特定原因死亡或复发、而其他死因很常见时,把其他事件当删失会高估累积发生率,应用累积发生函数和 Fine-Gray 模型。
随访截断
曲线尾部风险人数很少时估计不稳定。可在合理时间点截断展示,或报告限制平均生存时间(RMST),避免尾部的大幅跳跃影响解读。
常见错误
- 把失访或仍存活的患者当成事件发生:会严重低估生存,删失必须标记为 0 而不是剔除或记为事件。
- 用最佳切点分组后直接报告 Log-rank P 值:切点在同一数据上选出,P 值被系统性夸大,需在独立队列验证。
- 随访后才确定的分组当作基线分组:例如按是否完成全部疗程分组,会引入不朽时间偏倚,应使用里程碑分析。
- 不检验比例风险假设:HR 随时间明显变化时,单一 HR 会掩盖早期和晚期相反的效应。
- 多因素模型变量过多:事件数不足时 HR 置信区间极宽甚至模型不收敛,系数方向也可能随机翻转。
- 只报告 P 值不报告 HR 和置信区间:读者无法判断效应大小,大样本中很小的差异也会显著。
结果怎么看
Kaplan-Meier 曲线
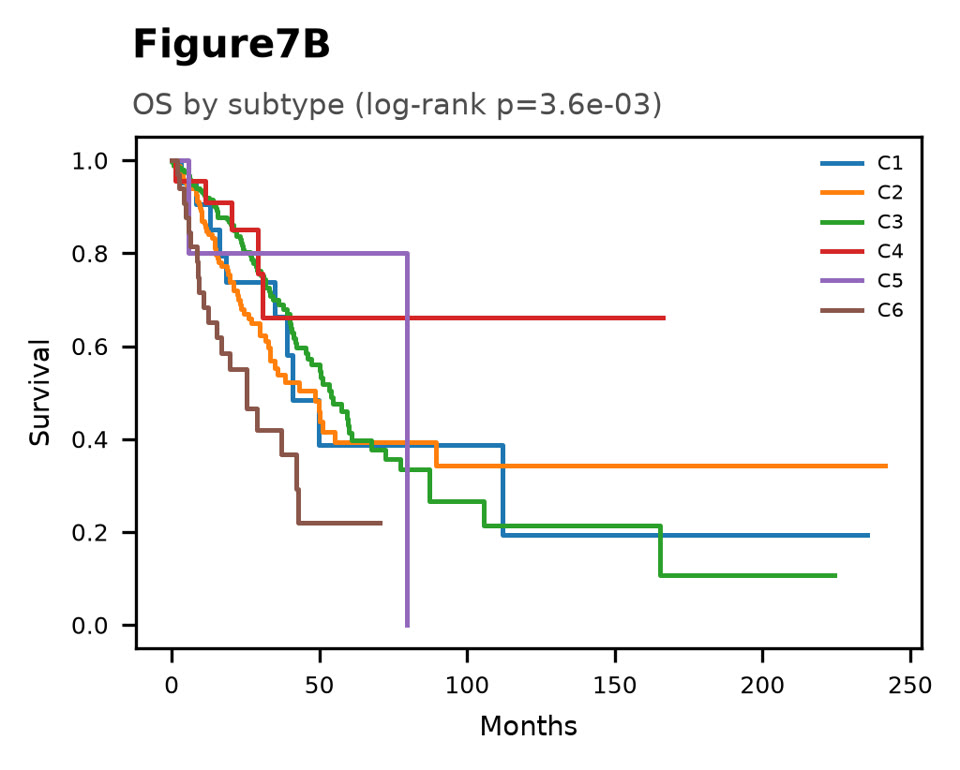
纵轴是生存概率,横轴是时间,竖线标记删失。看两条曲线是否持续分开、中位生存时间差多少。下方风险人数表显示尾部样本很少时,尾部差异不可靠;曲线交叉需谨慎解读。
Cox 回归结果表
列出每个变量的 HR、95% 置信区间和 P 值。HR 大于 1 表示风险升高,置信区间不跨 1 才算显著。HR 极大且区间很宽通常是某组事件过少或完全分离。
多因素森林图
每行一个变量,点为 HR,横线为置信区间,竖线为 HR 等于 1。看目标变量在校正后是否仍显著,以及效应方向是否与单因素一致;方向反转提示存在混杂或共线性。
比例风险检验结果
cox.zph 给出每个变量和整体的检验 P 值及 Schoenfeld 残差图。残差平滑线大致水平说明满足假设;明显上升或下降说明效应随时间变化。
和相近方法怎么选
Log-rank 检验与 Cox 回归
Log-rank 只比较组间生存曲线,无法校正其他变量,也不给出效应大小;Cox 回归给出 HR 并可同时纳入多个协变量。描述性比较用 KM 加 Log-rank,评估独立预后价值用多因素 Cox。
生存分析与预后模型
生存分析通常评估一个因素与预后的关系;预后模型把多个变量组合为风险评分,并需要区分度、校准度和外部验证。单基因预后评估属于前者,多基因风险评分属于后者。
Cox 回归与竞争风险模型
Cox 回归把其他事件当删失,估计的是原因别风险;Fine-Gray 模型估计考虑竞争事件后的累积发生率。研究病因机制常用前者,预测实际发生概率时用后者。
常见问题
KM 曲线的 P 值是怎么来的?
通常来自 Log-rank 检验,比较各组在每个事件时间点观察到的事件数与期望事件数的差异。图上标注的 P 值一般就是它。若曲线交叉,Log-rank 的检验力下降,P 值不显著不代表两组没有差异。
Cox 回归的 HR 怎么解释?
HR 是两组瞬时风险之比,在比例风险假设下随时间恒定。HR 等于 2 表示任一时间点上该组发生事件的风险约为参照组两倍,不等于生存时间缩短一半。连续变量的 HR 对应每增加一个单位。
单因素不显著能进多因素 Cox 吗?
可以。是否纳入应根据研究问题和临床知识,而不是单因素 P 值。只纳入单因素显著的变量会遗漏混杂因素,也会让模型选择依赖于数据,常见做法是预先指定需要校正的协变量。
比例风险假设不满足怎么办?
可以按违反假设的变量分层,让每层有自己的基线风险;加入该变量与时间的交互项,估计随时间变化的 HR;或按时间分段分别估计 HR。也可以改用 RMST 这类不依赖该假设的指标。
生存分析需要多少样本?
关键是事件数而不是总样本量。多因素 Cox 常用经验是每个变量约 10 个事件;比较两组时,可根据预期 HR、事件比例和检验水准做样本量估算。事件太少时只适合描述性分析。
在 Codar 里怎么做
在 Codar 里上传含随访时间和事件状态的临床表,或指定公共队列与目标基因并说明终点。Codar 确认方案后绘制 KM 曲线并做 Log-rank 检验,完成单因素、多因素 Cox 回归和比例风险检验,也可评估预后标志物。交付 KM 图、森林图、回归表、报告和可复现脚本。仅供科研,不替代临床决策。
这是 210 例结直肠癌患者的随访表,帮我按 CDX2 表达高低画 OS 和 DFS 的 KM 曲线,并在校正年龄和分期后做多因素 Cox