Bulk RNA-seq 差异表达分析
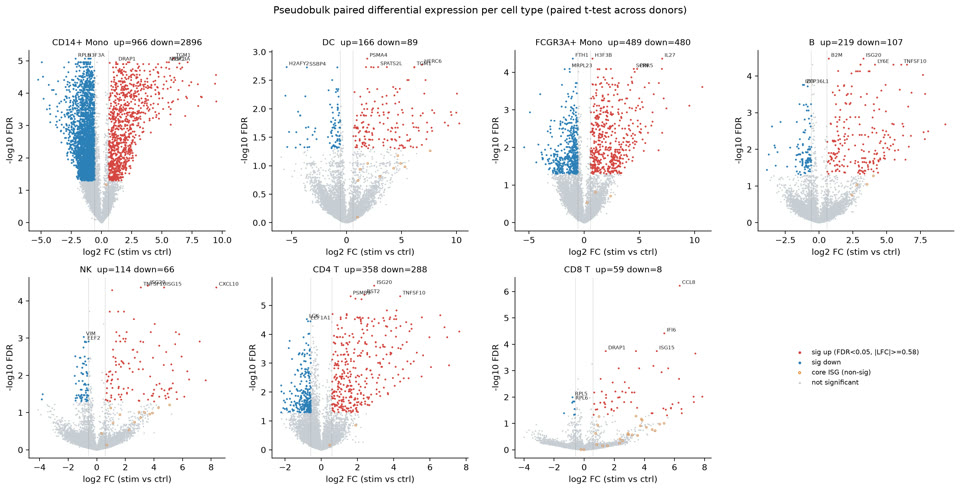
差异表达分析回答的问题是:两组或多组样本之间,哪些基因的表达变化超出了组内正常波动。Bulk RNA-seq 的输入是基因 × 样本的原始计数矩阵,计数离散且方差随均值增大,因此主流方法用负二项分布建模:DESeq2、edgeR 直接对计数建模,limma 通过 voom 转换为带权重的 log-CPM 后用线性模型。典型数据是处理组与对照组、每组若干生物学重复;单细胞数据聚合为 pseudobulk 后同样适用。输出每个基因的 log2 倍数变化、P 值和校正后 P 值,下游常接富集分析。
什么时候用
- 处理组与对照组比较,如药物处理、基因敲除、疾病与正常组织
- 多因素设计,如同时有处理和时间点,需要检验交互作用
- 配对样本设计,如同一患者的肿瘤与癌旁组织
- 单细胞数据按样本和细胞类型聚合为 pseudobulk 后做组间比较
- 为 GO / KEGG 富集或 GSEA 准备差异基因集和排序列表
不适合的情况
- 每组只有 1 个样本:无法估计组内离散度,P 值没有依据
- 已经 TPM、FPKM 或 log 转换的矩阵,不能直接输入 DESeq2 或 edgeR
- 表达芯片数据:应直接用 limma 对 log2 强度建模,不用计数模型
需要准备的数据
- 原始计数矩阵
- 基因 × 样本整数计数,来自 featureCounts、STAR 或经 tximport 汇总的 Salmon 结果
- 样本信息表
- 每个样本的分组、批次、配对编号;行名与计数矩阵列名完全一致且顺序相同,分组变量设为因子
- 基因注释表
- Ensembl ID 与基因名、基因类型的对照,版本与定量所用 GTF 一致,用于结果表注释
- 对比设定
- 明确参照组、比较方向和需要校正的协变量,多组实验列出每一组对比
分析步骤
- 1
核对计数与样本表
确认计数为整数,两表样本名和顺序一致,查看每个样本的总读段数和检出基因数。文库大小差几倍属正常,标准化会处理;某样本检出基因数明显偏少,要回头查上游比对率和 rRNA 比例。
- 2
过滤低表达基因
去除在大多数样本中计数接近 0 的基因。edgeR 的 filterByExpr 按最小组样本数和 CPM 自动判断;DESeq2 结果提取时有独立过滤,预先粗过滤主要用于减少内存和计算时间。
- 3
样本层面探索
用 DESeq2 的 vst 或 rlog 转换后做 PCA 和样本距离热图。同组样本应大体聚在一起;若主成分主要按测序批次或建库日期分开,就需要把批次写进设计公式。
- 4
写设计公式
常见写法如 ~ batch + condition,关注的变量放在最后;配对设计写作 ~ patient + condition。用 relevel 把对照组设为参照水平,否则按因子水平的字母顺序取第一个。
- 5
拟合与检验
DESeq2 运行 DESeq() 估计大小因子、离散度并做 Wald 检验;edgeR 常用 glmQLFit 加 glmQLFTest;limma-voom 用 voom、lmFit、eBayes。离散度图拟合曲线应随均值平滑下降。
- 6
提取结果与收缩
用 results() 的 contrast 或 name 提取指定对比,再用 lfcShrink 收缩低计数基因的倍数估计,用于排序和作图。显著性判断仍以 padj 为准,收缩只改变 log2FC。
- 7
筛选与可视化
按 padj 和 |log2FC| 阈值筛出差异基因,绘制火山图、MA 图和差异基因热图,输出带基因名的完整结果表(不只是显著基因),供富集分析和 GSEA 使用。
关键参数与决策
padj 阈值与 alpha
常用 padj < 0.05。DESeq2 的 results() 默认 alpha 为 0.1,是独立过滤优化时参照的水平;最终阈值用 0.05 时,建议把 alpha 也设为 0.05。
log2FC 阈值
常用 |log2FC| > 1(2 倍)作为经验阈值。更严谨的做法是在 results() 中设置 lfcThreshold,让假设检验本身针对超过该倍数的变化,而不是先检验再按倍数切一刀。
倍数收缩方法
lfcShrink 的 type 可选 apeglm、ashr、normal。apeglm 需用 coef 指定系数,任意对比可用 ashr。收缩后的 log2FC 更适合排序和 GSEA。
批次与隐藏因子
已知批次直接放进设计公式,而不是先用 ComBat 改写计数再分析。批次信息缺失时,可用 sva 或 RUVSeq 估计隐藏变异因子,作为协变量加入模型。
检验类型
两组或指定对比用 Wald 检验;多水平因子整体是否有效应、时间序列是否有任意时间点变化,用似然比检验(test 设为 LRT,并提供去掉该变量的简化模型 reduced)。
常见错误
- 样本表与计数矩阵列顺序错位:分组标签会被错配到别的样本上,所有结果都失真;导入前用代码逐一比对两者名字,而不是靠肉眼。
- 把技术重复当生物学重复:同一文库多次上机应先合并计数(DESeq2 提供 collapseReplicates),否则组内变异被低估,假阳性增多。
- 用未校正的 P 值筛基因:同时检验上万个基因,P < 0.05 本身就会带来数百个假阳性,结论应基于 BH 校正后的 padj。
- contrast 中分子组和分母组写反:上调和下调整体颠倒,与实验结论相反;每次都核对结果表头中「treated vs control」一类的比较说明。
- 批次与分组完全重合:处理组全在一批、对照组全在另一批时,任何模型都无法区分处理效应和批次效应,只能在实验设计阶段避免。
- 差异基因数不理想就反复调阈值:应先检查 PCA、离群样本和遗漏的协变量,阈值需在分析前确定并在方法中写明。
结果怎么看
差异结果表
每行一个基因,含 baseMean、log2FoldChange、lfcSE、pvalue、padj。padj 为 NA 通常是基因被独立过滤,或含 Cook 距离判定的离群计数,不等于不显著,可查明原因后再决定取舍。
火山图
横轴 log2FC,纵轴 -log10(padj)。若显著点几乎全偏向一侧,要怀疑标准化或某组含污染样本;少数点高高突出,常见于性别相关基因(如 XIST),先确认各组性别是否平衡。
MA 图
横轴平均表达量,纵轴 log2FC。低表达区呈喇叭口状大幅散开,说明倍数估计噪声大,应换用 lfcShrink 后的结果作图;点云整体中心明显偏离 0,提示标准化有问题。
PCA 图
用 vst 转换后的数据绘制。看 PC1 或 PC2 是否对应分组;某样本远离所有组时,先查它的比对率、rRNA 比例和建库记录,再决定是否剔除,并在报告中说明理由。
差异基因热图
通常取 padj 最小的若干基因,用 vst 值按行做 z-score。同组样本颜色模式应一致;若某个样本与同组整体相反,很可能是样本标签错误或样本混淆。
和相近方法怎么选
DESeq2 与 edgeR
两者都基于负二项模型,显著基因通常高度重叠。DESeq2 自带独立过滤、离群值处理和倍数收缩,默认流程完整;edgeR 的准似然 F 检验对假阳性控制较严格,设计灵活、运行快。选定一种为主分析并在方法中写明即可。
limma-voom 与计数模型
limma-voom 把计数转为 log-CPM 并估计观测权重,样本量大时速度快,对复杂设计和重复测量(duplicateCorrelation)支持好。每组样本很少或文库大小差异极大时,DESeq2、edgeR 更常用。
Bulk 与单细胞差异分析
单细胞比较条件时,若把每个细胞当独立重复做 Wilcoxon 检验,会把细胞数当样本量,P 值被严重低估。比较样本组应先按样本聚合为 pseudobulk,再用本页方法,具体见单细胞差异表达页。
差异表达与 GSEA
差异分析给出单个基因的显著性。当每个基因变化都温和、但整条通路协同变化时,按阈值截取会漏掉信号;此时用全部基因按统计量排序做 GSEA 更合适,两者常配合使用。
常见问题
没有生物学重复能做差异表达分析吗?
严格意义上不能。没有重复就无法估计组内变异,P 值缺乏依据。可以只报告倍数变化作为初筛,或按 edgeR 手册的建议人为设定一个经验离散度粗略估算,但结果只能作为后续实验的线索,不宜作为主要结论。
差异基因太少怎么办?
先看 PCA:如果组间本来就没有分离,说明处理效应弱或组内异质性大,增加重复比换方法更有效。再检查是否遗漏了批次、配对等信息,纳入后残差变小,检验功效会提高。不要改用未校正 P 值凑数。
DESeq2 和 edgeR 结果不一致,以哪个为准?
两者在中高表达、倍数较大的基因上结论通常一致,分歧多集中在低计数、处于阈值边缘的基因。事先选定一种作为主分析,另一种作为稳健性检查;结论依赖的关键基因用 qPCR 等独立方法验证。
火山图的阈值线怎么设?
横线对应 padj 阈值,padj = 0.05 时 -log10 约为 1.3;竖线对应 ±log2FC 阈值。图上的阈值必须与正文和结果表的筛选条件一致,改了阈值却没更新图,是审稿中常被指出的问题。
GEO 只提供 FPKM,能做差异分析吗?
不建议直接输入 DESeq2 或 edgeR。只有 FPKM 或 TPM 时,可 log2(x+1) 转换后用 limma 做近似分析并说明局限。更好的做法是查 GEO 是否有原始计数,或从 SRA 下载原始数据重新定量。
在 Codar 里怎么做
在 Codar 里描述分组和比较目标后,Codar 先确认比较方向、设计公式中的批次或配对项和筛选阈值,再读取本地计数矩阵和样本表运行 Bulk RNA-seq 差异表达分析,交付 PCA 图、火山图、MA 图、差异基因热图、带注释的完整结果表和可复现 R 脚本。
我有 3 个对照和 3 个敲低样本的 featureCounts 计数矩阵,分两批测序,请用 DESeq2 校正批次后做差异分析并画火山图