单细胞差异表达与差异丰度分析
单细胞数据的组间比较有两类问题:差异表达,即某细胞类型中哪些基因在病例与对照之间表达不同;差异丰度,即某类细胞或某个细胞状态在不同条件下的比例是否改变。差异表达的关键在于统计单位:同一个体的细胞不是独立样本,把每个细胞当作重复做检验会严重低估方差,产生大量假阳性。pseudobulk 方法把每个样本中同一细胞类型的计数相加,得到样本级表达矩阵,再用 DESeq2、edgeR 或 limma 等 bulk 方法分析。差异丰度可在细胞类型层面比较比例,也可用 Milo 在近邻图的局部邻域中检验。
什么时候用
- 比较病例与对照、处理与未处理在某一细胞类型中的基因表达差异
- 每组有多个生物学重复样本,需要样本级的统计推断
- 想知道疾病或处理是否改变了某类免疫细胞的比例
- 细胞状态变化是连续的,按簇比较比例会掩盖局部变化,适合用 Milo
- 为通路富集或 GSEA 准备可靠的细胞类型特异差异基因列表
不适合的情况
- 每组只有一个样本,pseudobulk 没有重复无法估计方差,只能做描述性比较
- 寻找簇的 marker 基因,这属于簇间比较,逐细胞检验即可,不需要 pseudobulk
- 细胞类型注释尚不可靠,按错误标签聚合会混合不同细胞类型的信号
需要准备的数据
- 原始计数矩阵
- pseudobulk 需要原始整数 UMI 计数,不能用归一化、对数化或整合后的值
- 细胞元数据
- 每个细胞的样本 ID、细胞类型、分组、批次;样本 ID 必须对应生物学重复而非测序通道
- 样本信息表
- 每个样本的分组、性别、批次等协变量,用于设计矩阵;配对设计需标明个体 ID
- 整合嵌入(Milo 需要)
- Milo 在 K 近邻图上定义邻域,多样本数据通常用整合后的低维嵌入构图
分析步骤
- 1
确认实验设计
明确比较的分组、每组生物学重复数以及需要校正的协变量,如批次、性别或配对个体。每组建议至少有 3 个以上的独立样本;重复太少时统计检验力很低,结论应偏向描述。
- 2
按样本和细胞类型聚合
对每个细胞类型,把同一样本中该类型细胞的原始计数逐基因相加,得到基因乘样本的矩阵。可用 Seurat 的 AggregateExpression、muscat 或 Scanpy 中的分组求和实现。剔除细胞数过少的样本与细胞类型组合。
- 3
bulk 方法差异分析
把聚合矩阵送入 DESeq2、edgeR 或 limma-voom,设计公式中写入分组和协变量。过滤低表达基因后运行。判断标准:P 值直方图应在接近 0 处有峰、其余部分平坦,若呈 U 形或右偏,提示模型设定有问题。
- 4
细胞类型比例比较
统计每个样本中各细胞类型的比例,用 propeller(speckle 包)或 scCODA 等方法检验。这些方法考虑了样本间变异或比例数据的组成性,比直接对细胞数做卡方检验更合理。
- 5
构建 Milo 邻域
在近邻图上抽样代表细胞,以其近邻定义部分重叠的邻域,统计每个邻域中来自各样本的细胞数。随后用负二项广义线性模型检验邻域丰度与分组的关系,并用空间 FDR 校正多重检验。
- 6
解读与下游
差异基因用于 GO、KEGG 富集或 GSEA;Milo 结果按细胞类型汇总,查看哪些类型内部有富集或缺失的邻域。检查效应是否由单个样本驱动,可对每个样本的表达或比例作图核对。
关键参数与决策
统计单位
组间比较的统计单位应是生物学样本而不是细胞。来自同一样本的细胞彼此相关,把它们当独立重复会造成伪重复,P 值极小但不可重复。这是 pseudobulk 方法的核心依据。
最少细胞数阈值
某样本中某细胞类型的细胞太少,聚合后的计数噪音大。常见做法是设置每个样本该类型的最少细胞数,不满足的组合剔除,阈值需结合数据量权衡,并在方法中说明。
设计公式与协变量
批次、性别、配对个体等写入设计公式,如在 DESeq2 中把批次放在分组之前。配对设计加入个体项可显著提高检验力。协变量不能与分组完全共线,否则模型无法估计。
Milo 邻域抽样比例与 K
makeNhoods 的 prop 参数决定抽样多少细胞作为邻域中心,K 决定邻域大小。K 太小时每个邻域细胞少、检验力低;太大则局部分辨率下降。可通过邻域大小分布图调整,使多数邻域包含足够细胞。
多重检验与显著性阈值
差异表达通常用 BH 校正后的 padj 小于 0.05,并结合倍数变化阈值;Milo 使用考虑邻域重叠的空间 FDR。同时检验多个细胞类型时,应在报告中说明是否对细胞类型数做了进一步校正。
常见错误
- 用逐细胞 Wilcoxon 检验比较病例和对照:细胞数越多 P 值越小,成千上万个基因被判为显著,多数结果无法在独立样本中重复。
- 用 SCTransform 或整合后的矩阵做 pseudobulk:这些值已非原始计数,送入 DESeq2 会破坏负二项模型假设,导致方差估计错误。
- 把测序通道或技术重复当作独立样本:同一个体拆成多个通道并不增加生物学重复,会夸大样本量和显著性。
- 直接比较细胞类型比例的绝对数值:比例是组成数据,一类细胞增加会让其他类型比例被动下降,需用考虑组成性的方法并谨慎解读。
- 解离或富集方式在组间不同时比较比例:CD45 分选、组织解离效率差异都会改变比例,此时比例差异更多反映实验操作。
- 差异基因只看 padj 不看表达量:某细胞类型中表达极低的基因倍数变化不稳定,应结合平均表达和 MA 图判断。
结果怎么看
各细胞类型差异基因表
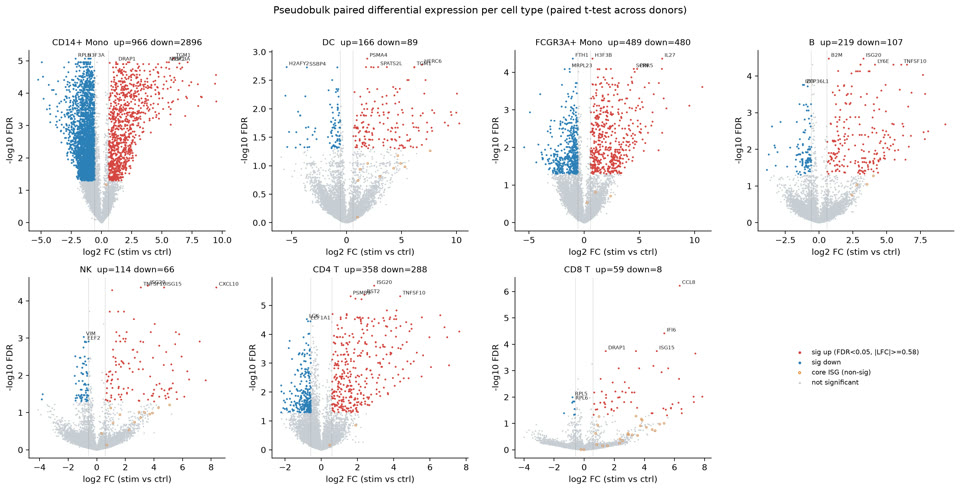
每个细胞类型一张表,包含 log2 倍数变化、P 值和 padj。关注在多个细胞类型中方向一致的基因与只在特定类型中变化的基因;某类型差异基因数极少,可能是该类型样本细胞数不足导致检验力低。
火山图与 MA 图
火山图展示效应大小与显著性,MA 图展示倍数变化与平均表达的关系。MA 图中低表达区的点应围绕 0 对称;若整体偏离 0,提示聚合后文库大小差异未被正确校正。
样本级 pseudobulk PCA
对每个细胞类型的聚合矩阵做 PCA,按分组和批次着色。分组在主成分上分开说明组间差异较大;若按批次或个体分开,需在设计公式中加入相应协变量。
细胞比例箱线图
每个点代表一个样本中某细胞类型的比例,按分组比较。比单纯的堆叠柱状图更能看出样本间变异;显著差异若由一两个离群样本驱动,结论需要谨慎。
Milo 邻域图与蜂群图
邻域图上每个点是一个邻域,颜色为丰度对数倍数变化,仅显著邻域着色。蜂群图按细胞类型展示邻域倍数变化,可看出差异集中在某类型的局部子群,还是整体上移或下移。
和相近方法怎么选
pseudobulk 与逐细胞检验
逐细胞检验(如 FindMarkers 默认的 Wilcoxon)适合找簇间 marker。组间比较时把细胞当独立重复,会低估方差、产生大量假阳性。有多个生物学重复时应优先用 pseudobulk;混合效应模型也可行,但计算更重。
单细胞 pseudobulk 与 bulk RNA-seq 差异分析
pseudobulk 后的统计流程与 bulk RNA-seq 相同,都用 DESeq2、edgeR 等。区别是 pseudobulk 先按细胞类型拆分,结果是细胞类型特异的,不受组成变化干扰;bulk 数据中的差异可能只是细胞比例改变造成的。
按簇比较比例与 Milo
按簇比较比例依赖聚类结果,簇内只有部分细胞状态变化时会被稀释。Milo 在重叠的局部邻域上检验,不需预先定义簇,能发现簇内局部的富集或缺失,但结果解读需要结合注释汇总,且对近邻图构建较敏感。
常见问题
单细胞差异分析为什么要用 pseudobulk?
因为同一样本的细胞不独立。逐细胞检验把几千个细胞当作几千个重复,方差被大大低估,P 值失真。pseudobulk 把统计单位还原为样本,方差反映的是个体间差异,结果更可重复,假阳性更少。
FindMarkers 的结果能当组间差异基因吗?
用来找簇的 marker 没有问题。用来比较病例与对照时,若不考虑样本结构,结果会有大量假阳性。建议改用 pseudobulk 加 DESeq2 或 edgeR,或至少确认主要结论在样本级别成立。
每组只有 2 个样本能做 pseudobulk 吗?
技术上可以运行,但统计检验力很低,方差估计不稳定,显著结果很少且可靠性有限。这种情况下应把结果视为探索性,重点看效应方向和大小,并在后续用更多样本或其他实验验证。
细胞比例差异用什么方法检验?
常用方法有 propeller、scCODA,以及基于邻域的 Milo。前两者在细胞类型层面比较,考虑了样本间变异或组成性;Milo 适合细胞状态连续变化的情况。直接对汇总细胞数做卡方检验会忽略样本间变异。
Milo 结果显示某细胞类型既有富集又有缺失的邻域,怎么解释?
说明该细胞类型内部存在不同状态,在条件间朝不同方向变化。例如同为巨噬细胞,炎症状态的子群增加、静息状态的子群减少。可将显著邻域的细胞取出比较 marker,进一步定义这些子状态。
在 Codar 里怎么做
在 Codar 里说明分组、样本数量和关心的细胞类型后,会先确认比较设计、协变量和最少细胞数阈值。差异表达部分按样本和细胞类型聚合原始计数,用 Bulk RNA-seq 差异表达分析流程检验;差异丰度部分比较细胞类型比例或邻域丰度。交付差异基因表、火山图、样本级 PCA、细胞比例图、差异丰度图和可复现脚本。
我有 IFN-β 刺激与对照各 8 例 PBMC 单细胞数据,已注释细胞类型,帮我按样本做 pseudobulk 差异分析,并检验各细胞类型比例是否改变