Seurat 与 Scanpy
两者是最常用的单细胞分析框架,分别基于 R 和 Python,覆盖质控、标准化、聚类和可视化。选哪个主要看团队习惯和下游工具;两种格式可以互转,但转换后要核对元数据和降维结果是否完整。
 Codar
39个分析 Skill · Codar 生信插件
单细胞研究在单个细胞分辨率上刻画细胞类型、状态和相互作用,常见数据是 scRNA-seq、scATAC-seq 和 CITE-seq 计数矩阵。Codar 的这个插件覆盖质控、双细胞与环境 RNA 校正、批次整合、聚类注释、轨迹与 RNA 速度、细胞通讯,以及 Perturb-seq 和虚拟敲除预测。
读取 10x 输出、h5ad 或 Seurat 对象,按 UMI 数、基因数和线粒体比例过滤,阈值参考样本分布来定。
识别双细胞,校正环境 RNA 污染;多个样本时先评估批次效应,再决定是否整合及用哪种方法。
选取高变基因,做 PCA、邻接图聚类和 UMAP,聚类分辨率要结合标记基因反复确认。
结合已知标记基因和参考图谱映射注释细胞类型,对难以判断的簇保留原标签再核查。
按研究问题做差异丰度、伪时间轨迹、RNA 速度、细胞通讯或扰动效应分析。
输出 UMAP、点图、细胞比例图和通讯网络图,以及带注释的 h5ad 文件和分析脚本。
两者是最常用的单细胞分析框架,分别基于 R 和 Python,覆盖质控、标准化、聚类和可视化。选哪个主要看团队习惯和下游工具;两种格式可以互转,但转换后要核对元数据和降维结果是否完整。
Harmony 在 PCA 空间校正批次,速度快;scVI 用深度生成模型直接建模原始计数,适合样本多、批次复杂的数据;BBKNN 通过调整邻接图整合。整合过度会抹掉真实差异,校正后要检查已知细胞类型是否仍能区分。
CellTypist 用预训练模型自动注释,免疫细胞模型较完善;SingleR 把细胞与带标签的参考表达谱比较;Seurat 参考映射可把数据投射到已有图谱。自动注释适合作起点,最终标签仍要用标记基因核对。
CellChat 和 CellPhoneDB 根据配体-受体对的表达推断细胞间通讯;NicheNet 进一步把配体与靶细胞的下游基因变化联系起来。这些结果基于表达推断,不等于实际的蛋白互作,需要空间数据或实验支持。
共 39 项。启用插件后,Codar 会按任务自动选用,不需要逐个记住名称。
在 Codar 左上角选择 Codar 生信。
在插件页找到「单细胞与虚拟细胞」,安装或启用。
用一句话写清数据和目标,确认分析方案后开始执行。
帮我基于 GSE96583 单细胞转录组数据,解析 IFN-β 刺激后 PBMC 的细胞类型特异性响应。
比较不同样本组之间的差异时,通常建议先按样本和细胞类型聚合成 pseudobulk,再用 DESeq2 或 edgeR 分析。把每个细胞当作独立样本会忽略样本间变异,p 值偏小、假阳性偏多。单细胞层面的检验更适合找各簇的标记基因。
通常需要。双细胞会形成看似处于中间状态的假簇,常用 scDblFinder、DoubletFinder 识别;环境 RNA 会让本不表达的基因出现在多种细胞中,可用 SoupX 或 CellBender 校正。这两步一般放在聚类和注释之前。
伪时间分析(如 Monocle3、Slingshot)按表达相似性给细胞排序,起点需要指定,本身不判断方向;RNA 速度(如 scVelo)利用未剪接与已剪接读段的比例估计变化方向,对变化较快的分化过程更有参考价值。
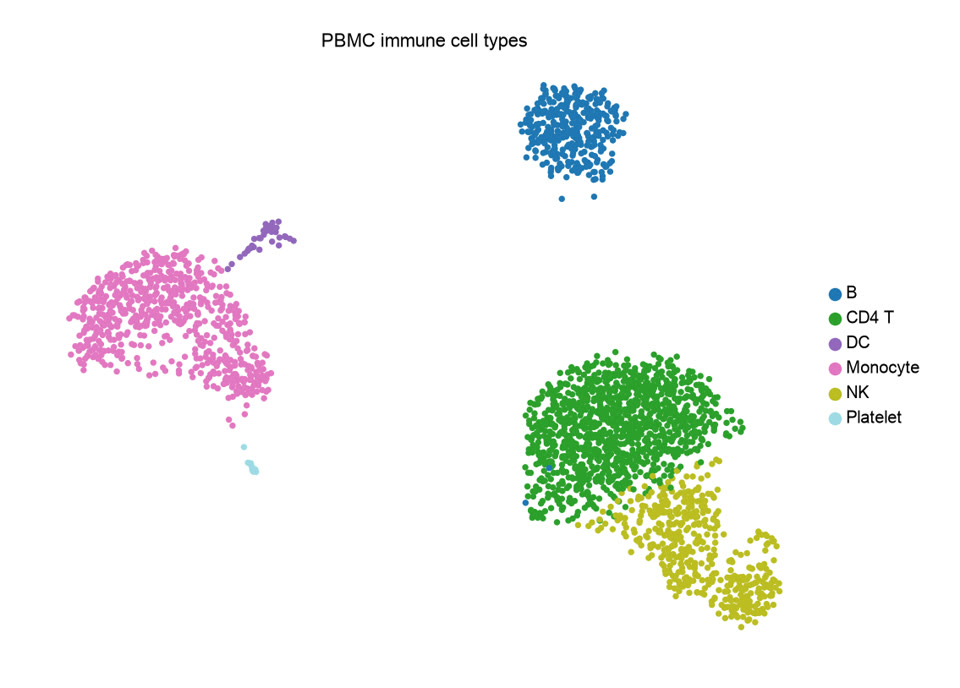 单细胞 · 免疫图谱
10x Genomics PBMC 3k 数据:质控、Leiden 聚类、细胞类型注释与 Marker 验证。
阅读案例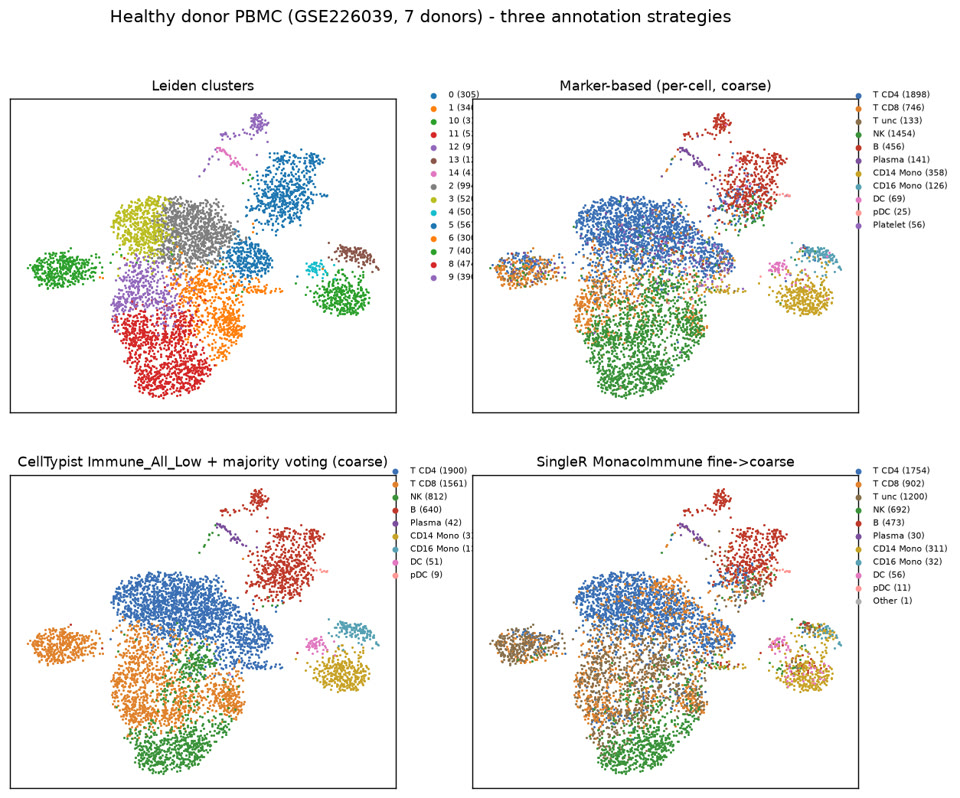 单细胞 · 细胞注释
CellTypist、SingleR 与经典 Marker 三种方法交叉比较,量化一致率、κ 与 ARI。
阅读案例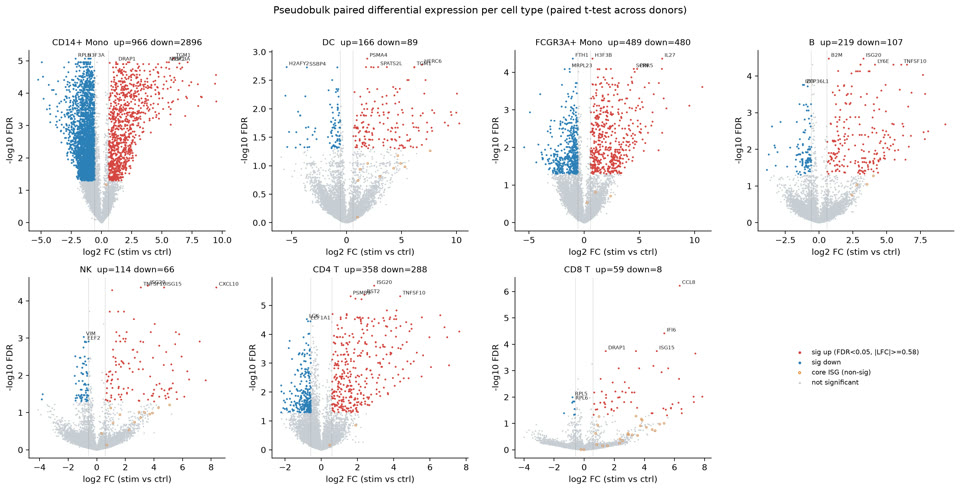 单细胞 · 差异表达
GSE96583,8 名供体配对伪 bulk 分析:CD14+ 单核细胞响应最强,35 个基因在 7 类细胞中共同上调。
阅读案例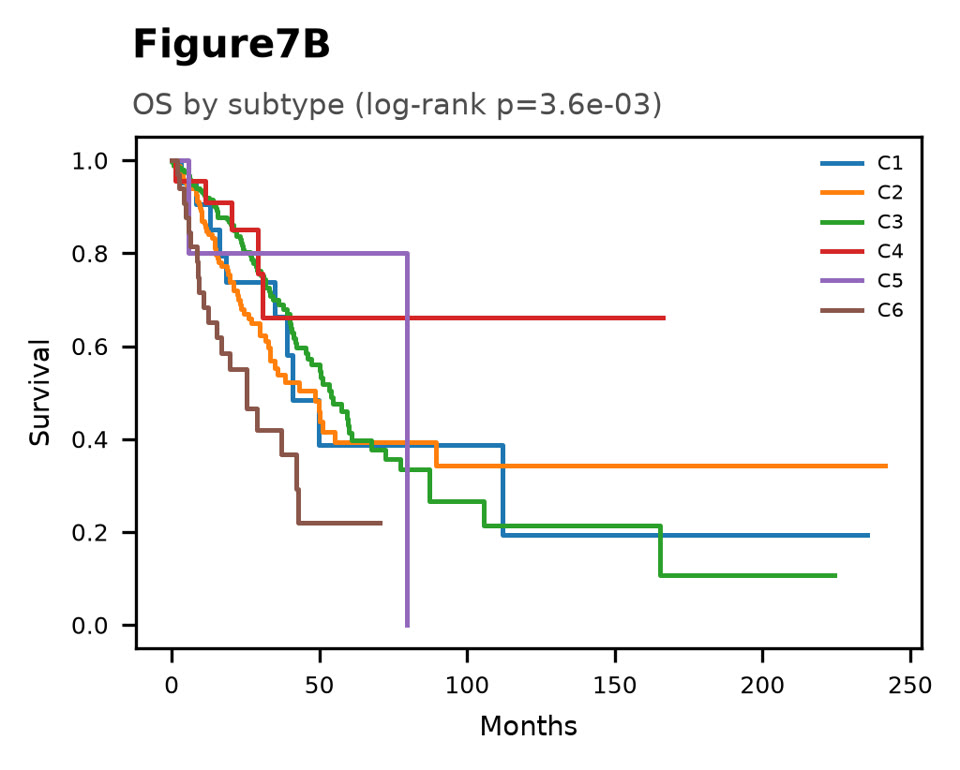 肿瘤 · 生存分析
GSE131907 恶性细胞 NMF 分型,结合肿瘤微环境分析,并在 TCGA-LUAD 队列中探索生存关联。
阅读案例