
单细胞细胞注释方法对比:CellTypist、SingleR 与 Marker 一致性分析(GSE226039)
基于 GSE226039 健康人 PBMC 数据,用 CellTypist、SingleR 和经典 Marker 分别完成细胞类型注释,并用一致率、Cohen's κ、ARI 和 NMI 比较三种方法的一致性与分歧。
#案例目标
基于健康人 PBMC 单细胞转录组数据,分别使用 CellTypist、SingleR 和经典 Marker 基因完成细胞类型注释,比较三种方法的总体一致性、分类型一致性及系统性分歧,形成可复查的共识注释结果。
#研究背景
细胞类型注释是单细胞 RNA 测序分析的关键步骤。自动注释工具效率高,但结果会受到训练模型、参考数据集和标签粒度影响;Marker 注释更便于结合生物学知识,但也包含人为判断。
本案例使用同一批健康人 PBMC,同时运行三种注释策略并统一标签体系。分析重点不是把某一种方法视为标准答案,而是识别三种方法都支持的稳定结果和需要进一步验证的分歧细胞群。
#研究方法
- 选取 GSE226039 中 7 名健康供体的 PBMC 数据,完成质量控制、标准化、特征选择、PCA、Leiden 聚类和 UMAP。
- 使用 CellTypist
Immune_All_Low模型进行逐细胞预测,并结合高分辨率过聚类执行 majority voting。 - 使用 SingleR 分别结合 MonacoImmuneData 和 BlueprintEncodeData 参考集进行注释,主分析采用 MonacoImmuneData。
- 使用 11 组经典 Marker 基因计算细胞类型得分,完成逐细胞及逐簇注释。
- 将不同工具的原始标签映射至统一的 12 类粗粒度词表,再计算一致率、Cohen's κ、ARI 和 NMI。
- 汇总三方一致、2-of-3 多数和三方各异结果,并分析细胞类型、供体测序深度和参考集对一致性的影响。
#研究目标
- 获得经过统一预处理的健康人 PBMC 数据集。
- 分别生成 CellTypist、SingleR 和 Marker 注释结果。
- 量化三种方法的两两一致性和三方共识比例。
- 定位 T 细胞、NK 细胞和单核细胞中的系统性混淆。
- 评估测序深度与 SingleR 参考集选择对结果的影响。
- 输出逐细胞标签、共识状态、统计矩阵和可复现脚本。
#拟解决的关键问题
- 三种注释方法在统一标签体系下的一致程度如何?
- 哪些 PBMC 细胞类型最容易获得稳定共识?
- 哪些细胞类型存在重复出现的系统性分歧?
- 簇级注释是否比逐细胞注释更稳定?
- 测序深度和参考集选择会在多大程度上影响注释结果?
#分析流程
- 下载并整理 GSE226039 中 7 个健康人 PBMC 样本。
- 完成质量控制、标准化和高变基因筛选。
- 运行 PCA、邻居图、Leiden 聚类和 UMAP。
- 分别执行 CellTypist、SingleR 和 Marker 注释。
- 将三种方法的标签映射至共享粗粒度词表。
- 计算两两一致率、Cohen's κ、ARI 和 NMI。
- 生成三方共识标签并统计各细胞类型的分歧。
- 分析供体测序深度和 SingleR 参考集敏感性。
- 导出结果表、图件、处理后数据和分析脚本。
#数据准备
#数据来源
- 数据集:GSE226039
- 研究对象:7 名健康供体的 PBMC
- 样本编号:GSM7061878、GSM7061881、GSM7061884、GSM7061887、GSM7061890、GSM7061893 和 GSM7061896
- 原始规模:5,462 个细胞、33,538 个基因
- 数据格式:10x v2 表达矩阵
- 参考基因组:GRCh38
#用户操作教程
#第一步:创建任务
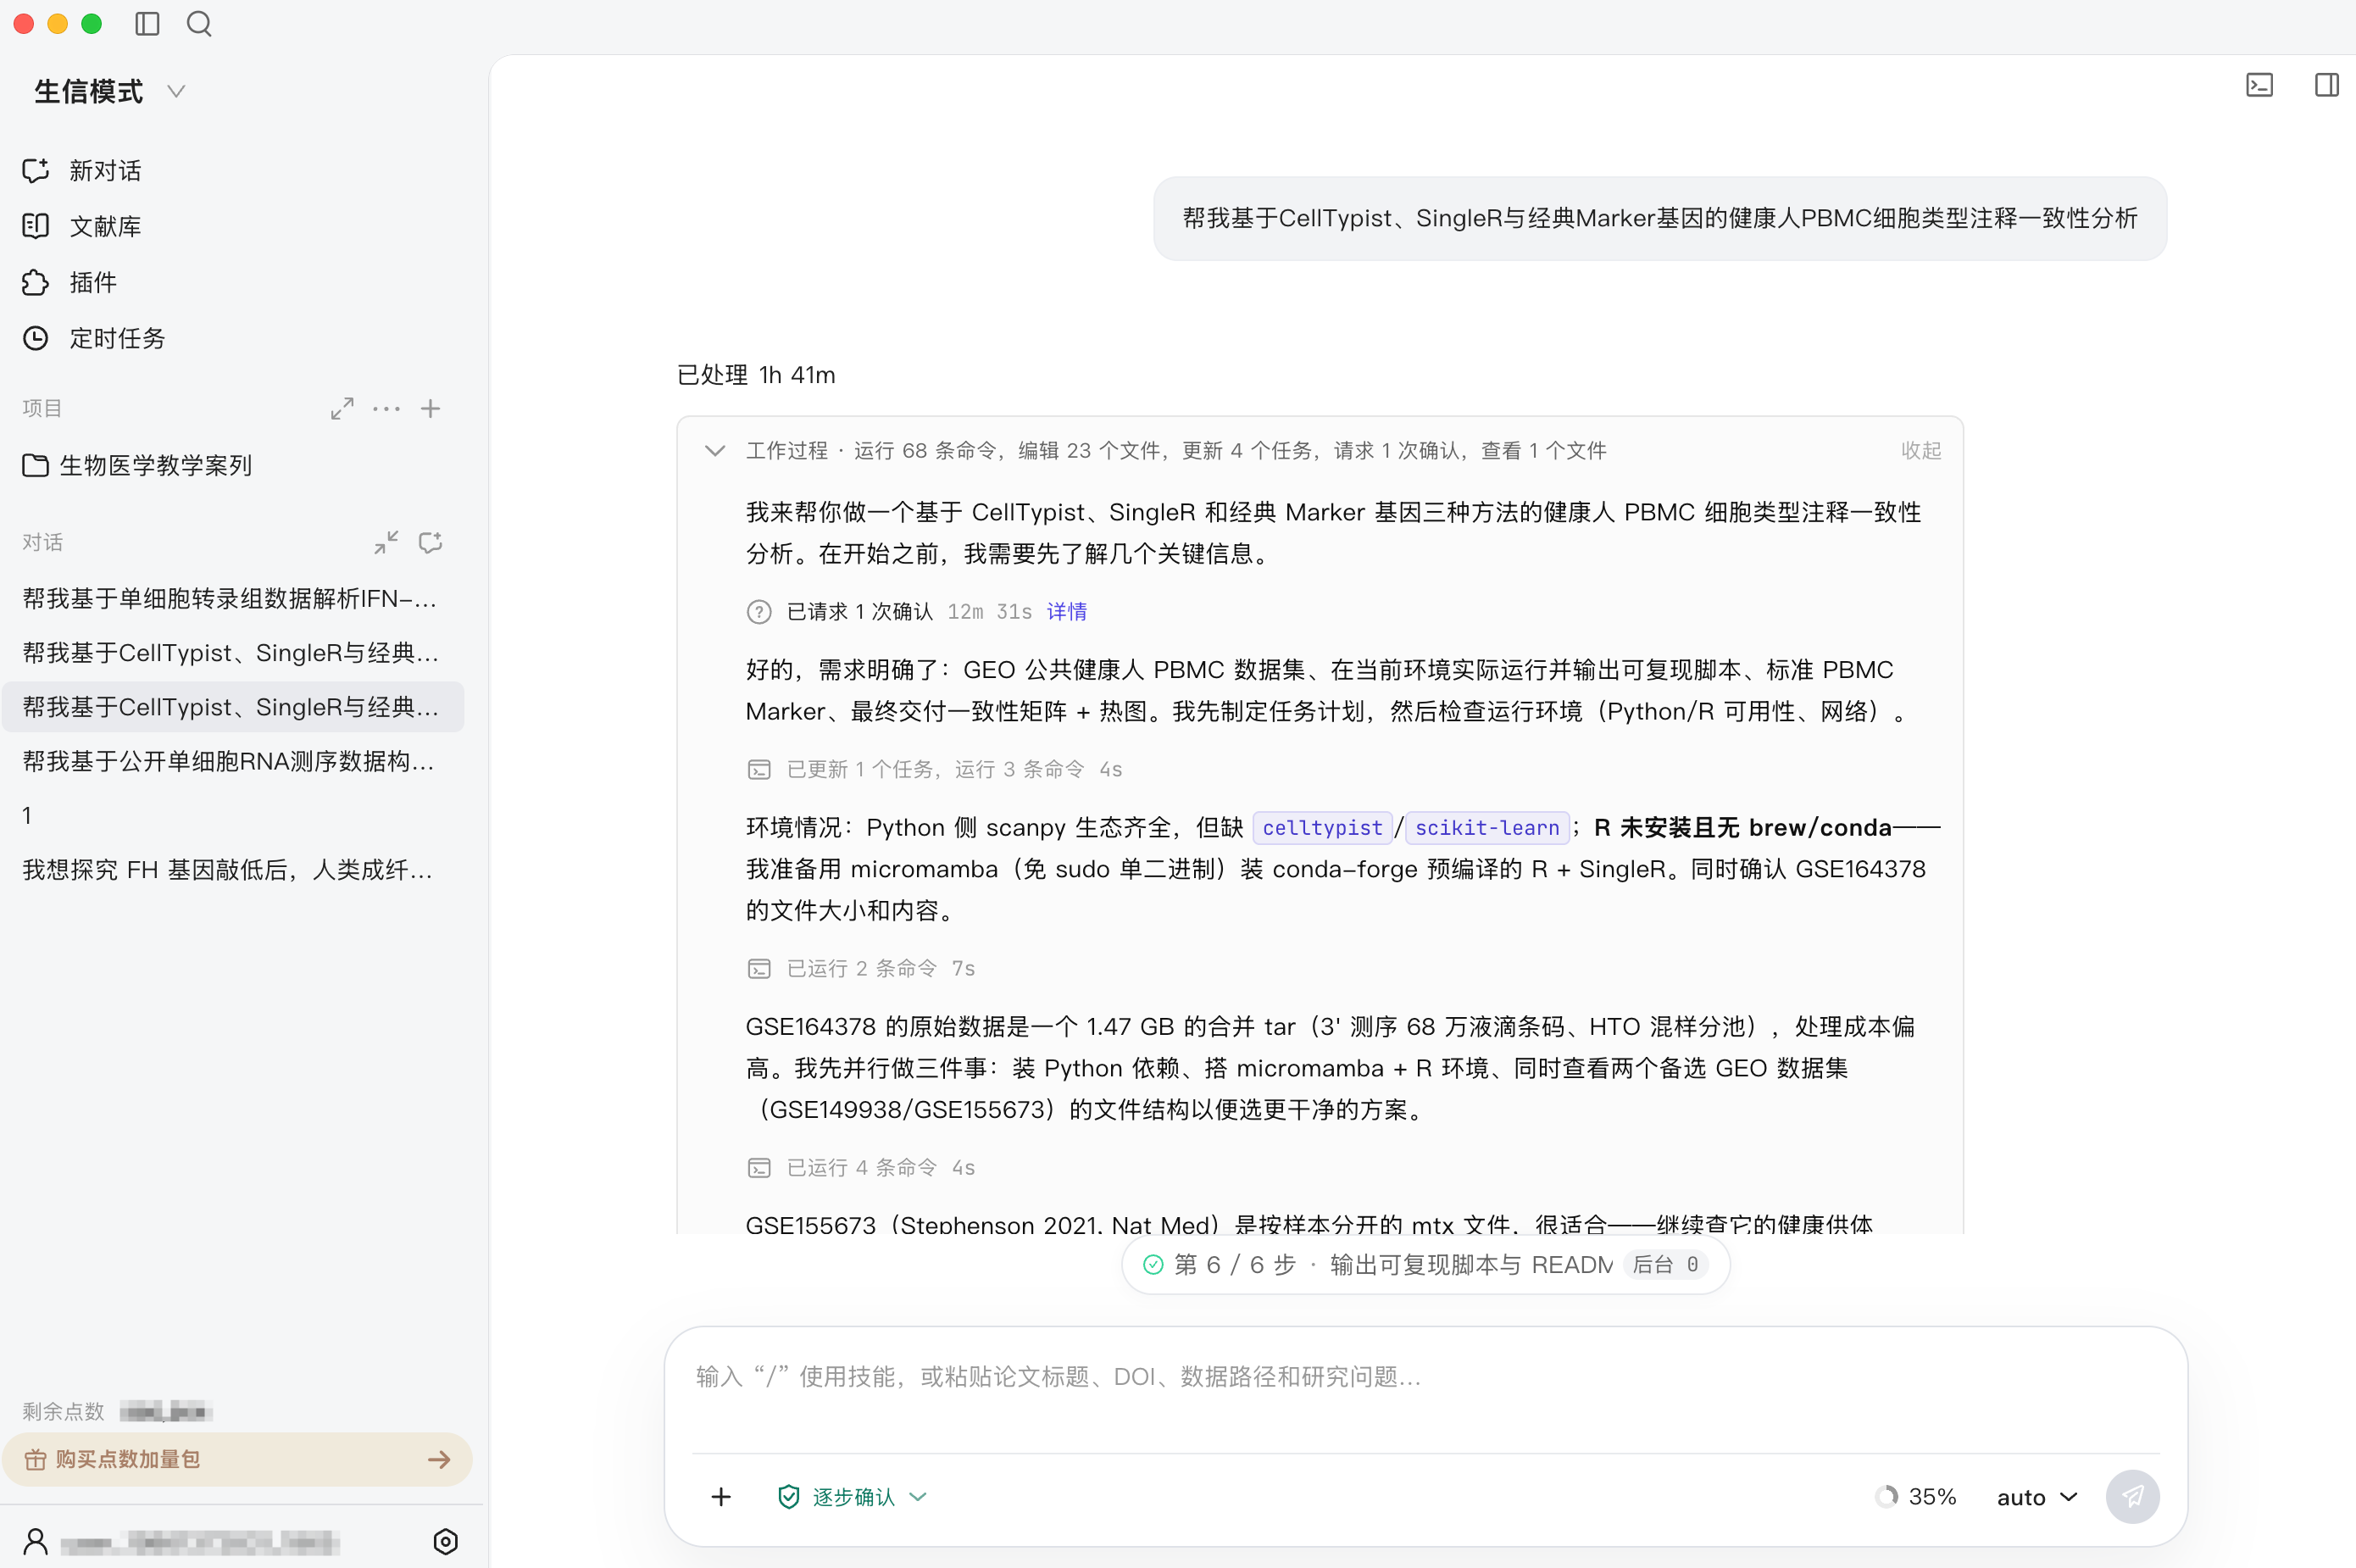
- 打开 Codar,在左上角选择 生信模式。
- 点击 新对话,输入任务:
帮我基于 CellTypist、SingleR 与经典 Marker 基因,对健康人 PBMC 进行细胞类型注释一致性分析。
- 发送任务后,补充确认数据来源、注释方法和期望产出。
#第二步:确认分析方案
建议在方案确认时保留以下内容:
- 数据范围:GSE226039 中健康供体 PBMC
- 自动注释:CellTypist 与 SingleR
- 人工知识验证:经典 Marker 基因评分
- 一致性指标:一致率、Cohen's κ、ARI、NMI 和三方共识状态
- 输出内容:逐细胞标签、混淆矩阵、共识结果、结果图和可复现脚本
确认后提交回答,Codar 会生成执行计划并开始分析。
#第三步:查看注释结果
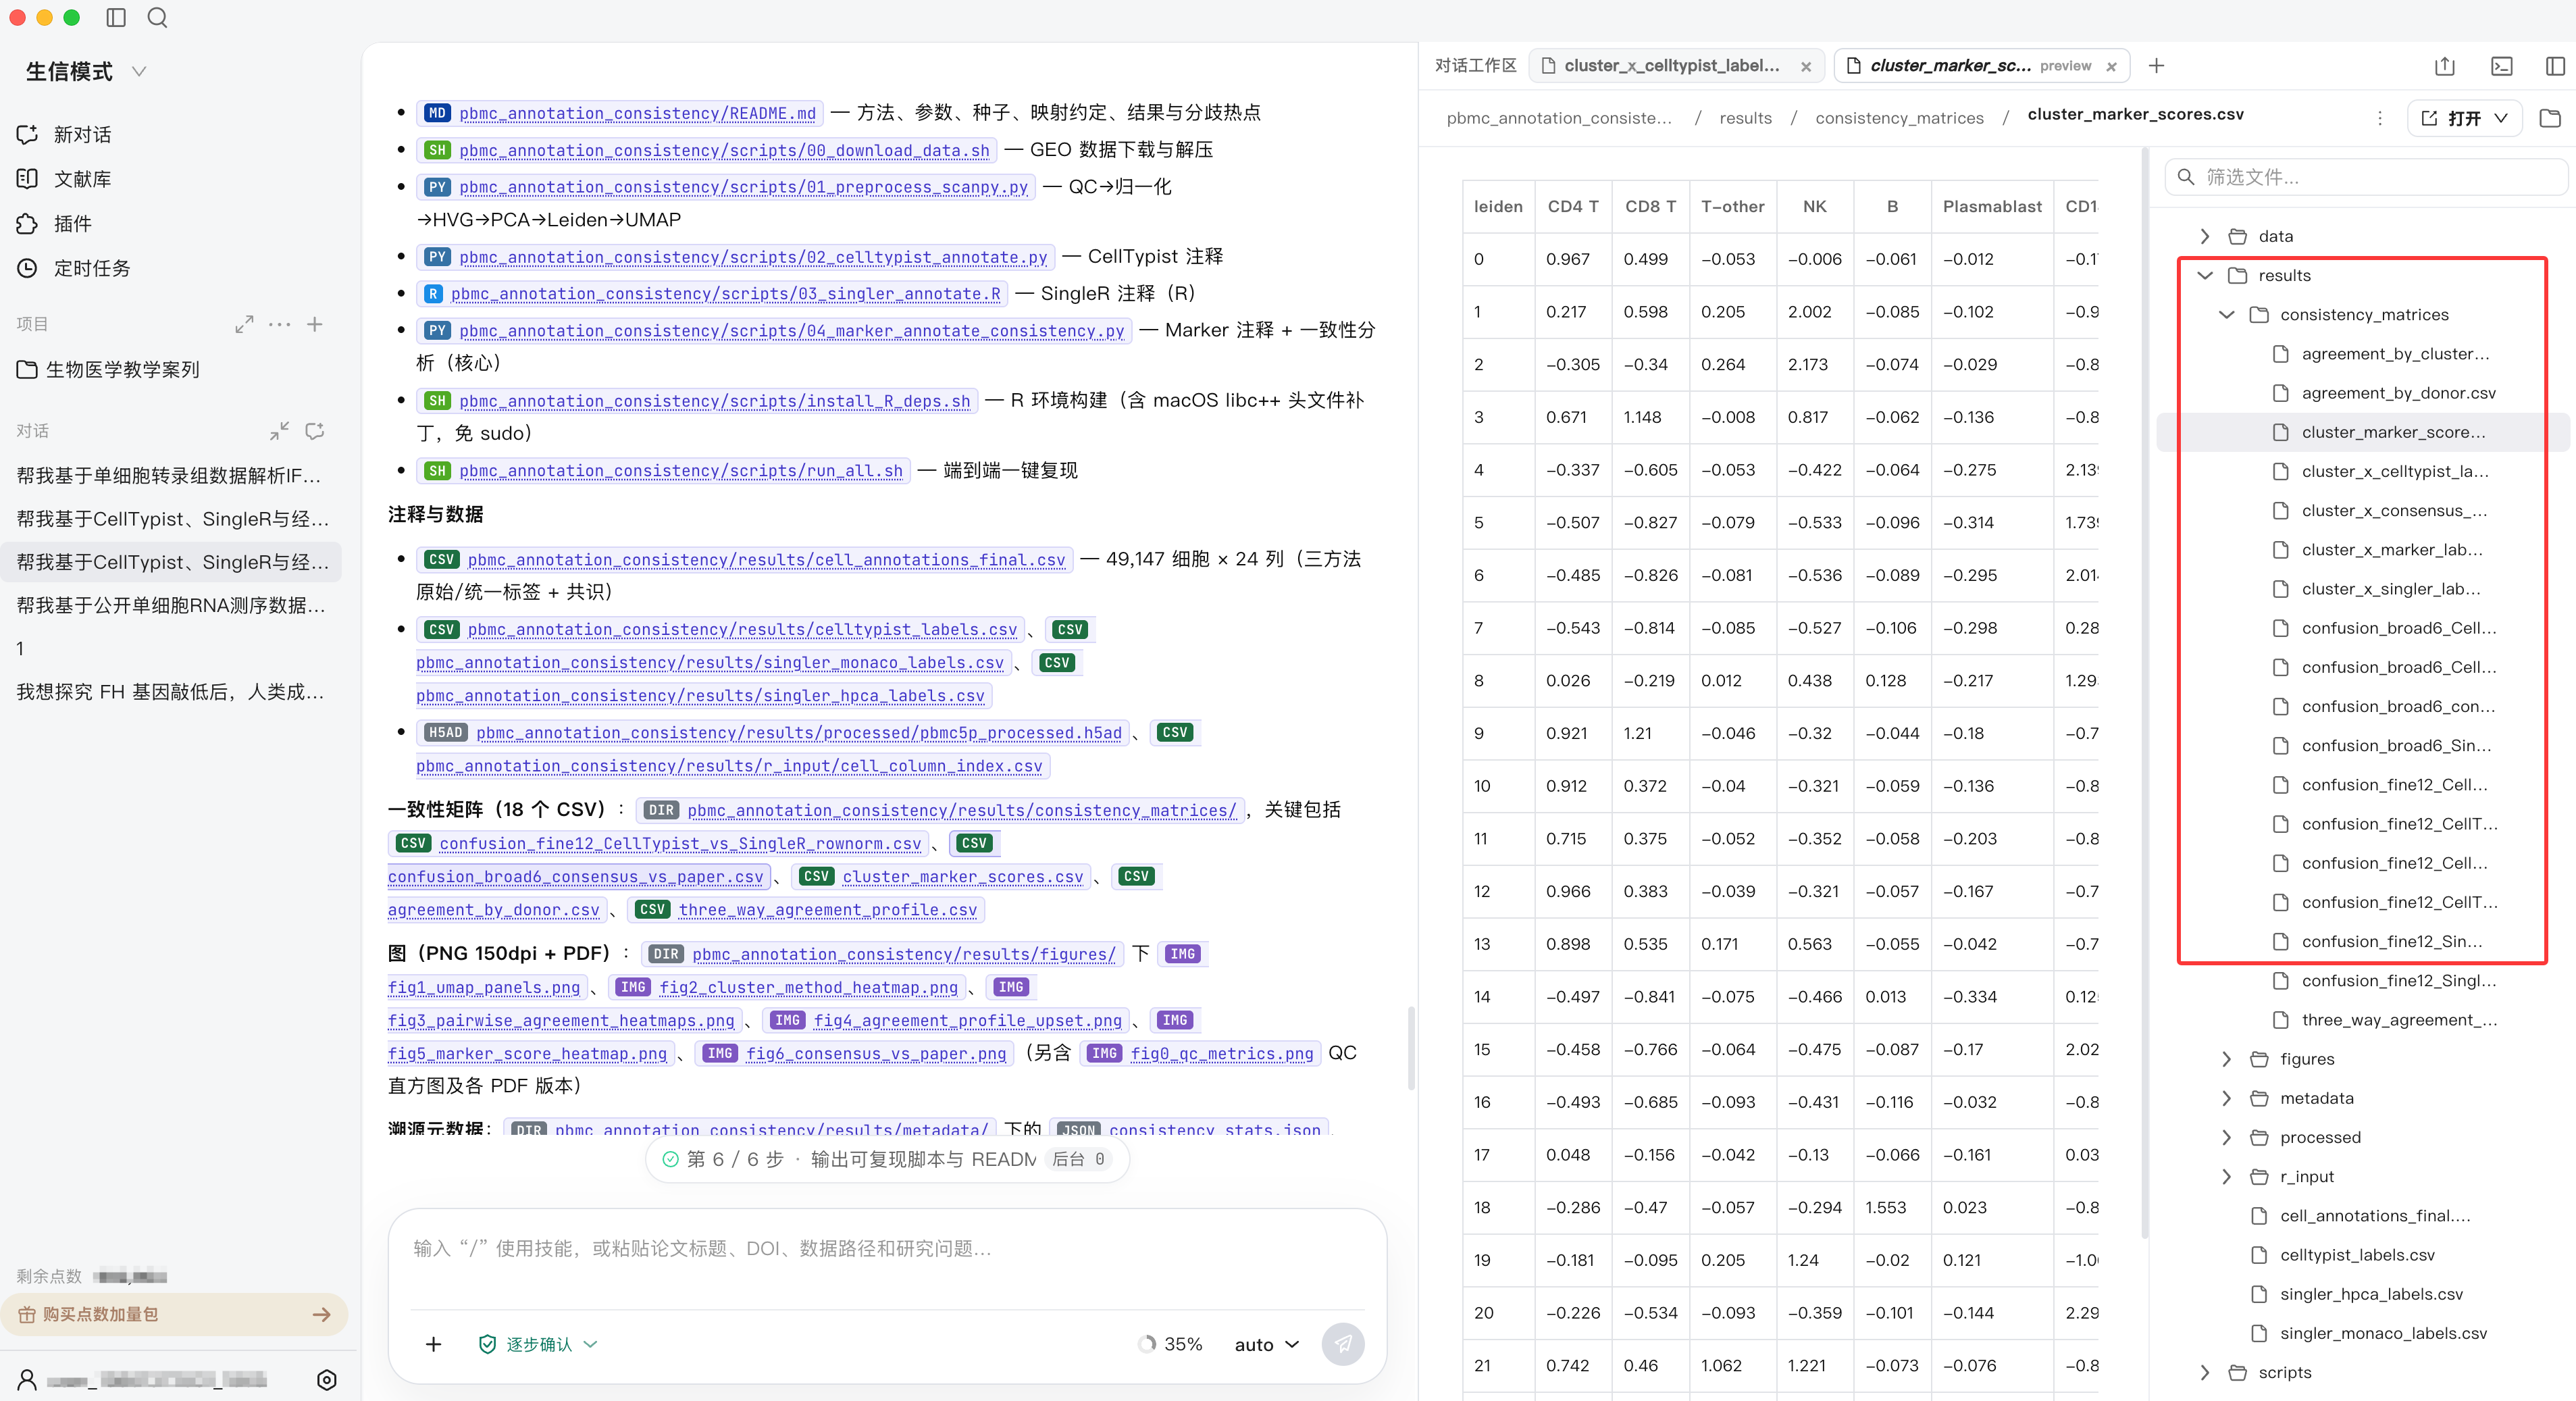
任务完成后,在结果产出区打开 results 文件夹。建议优先查看逐细胞标签、三方共识状态、一致性指标和标签映射表,再结合 UMAP 判断分歧是否集中在特定区域。
#第四步:查看可视化结果
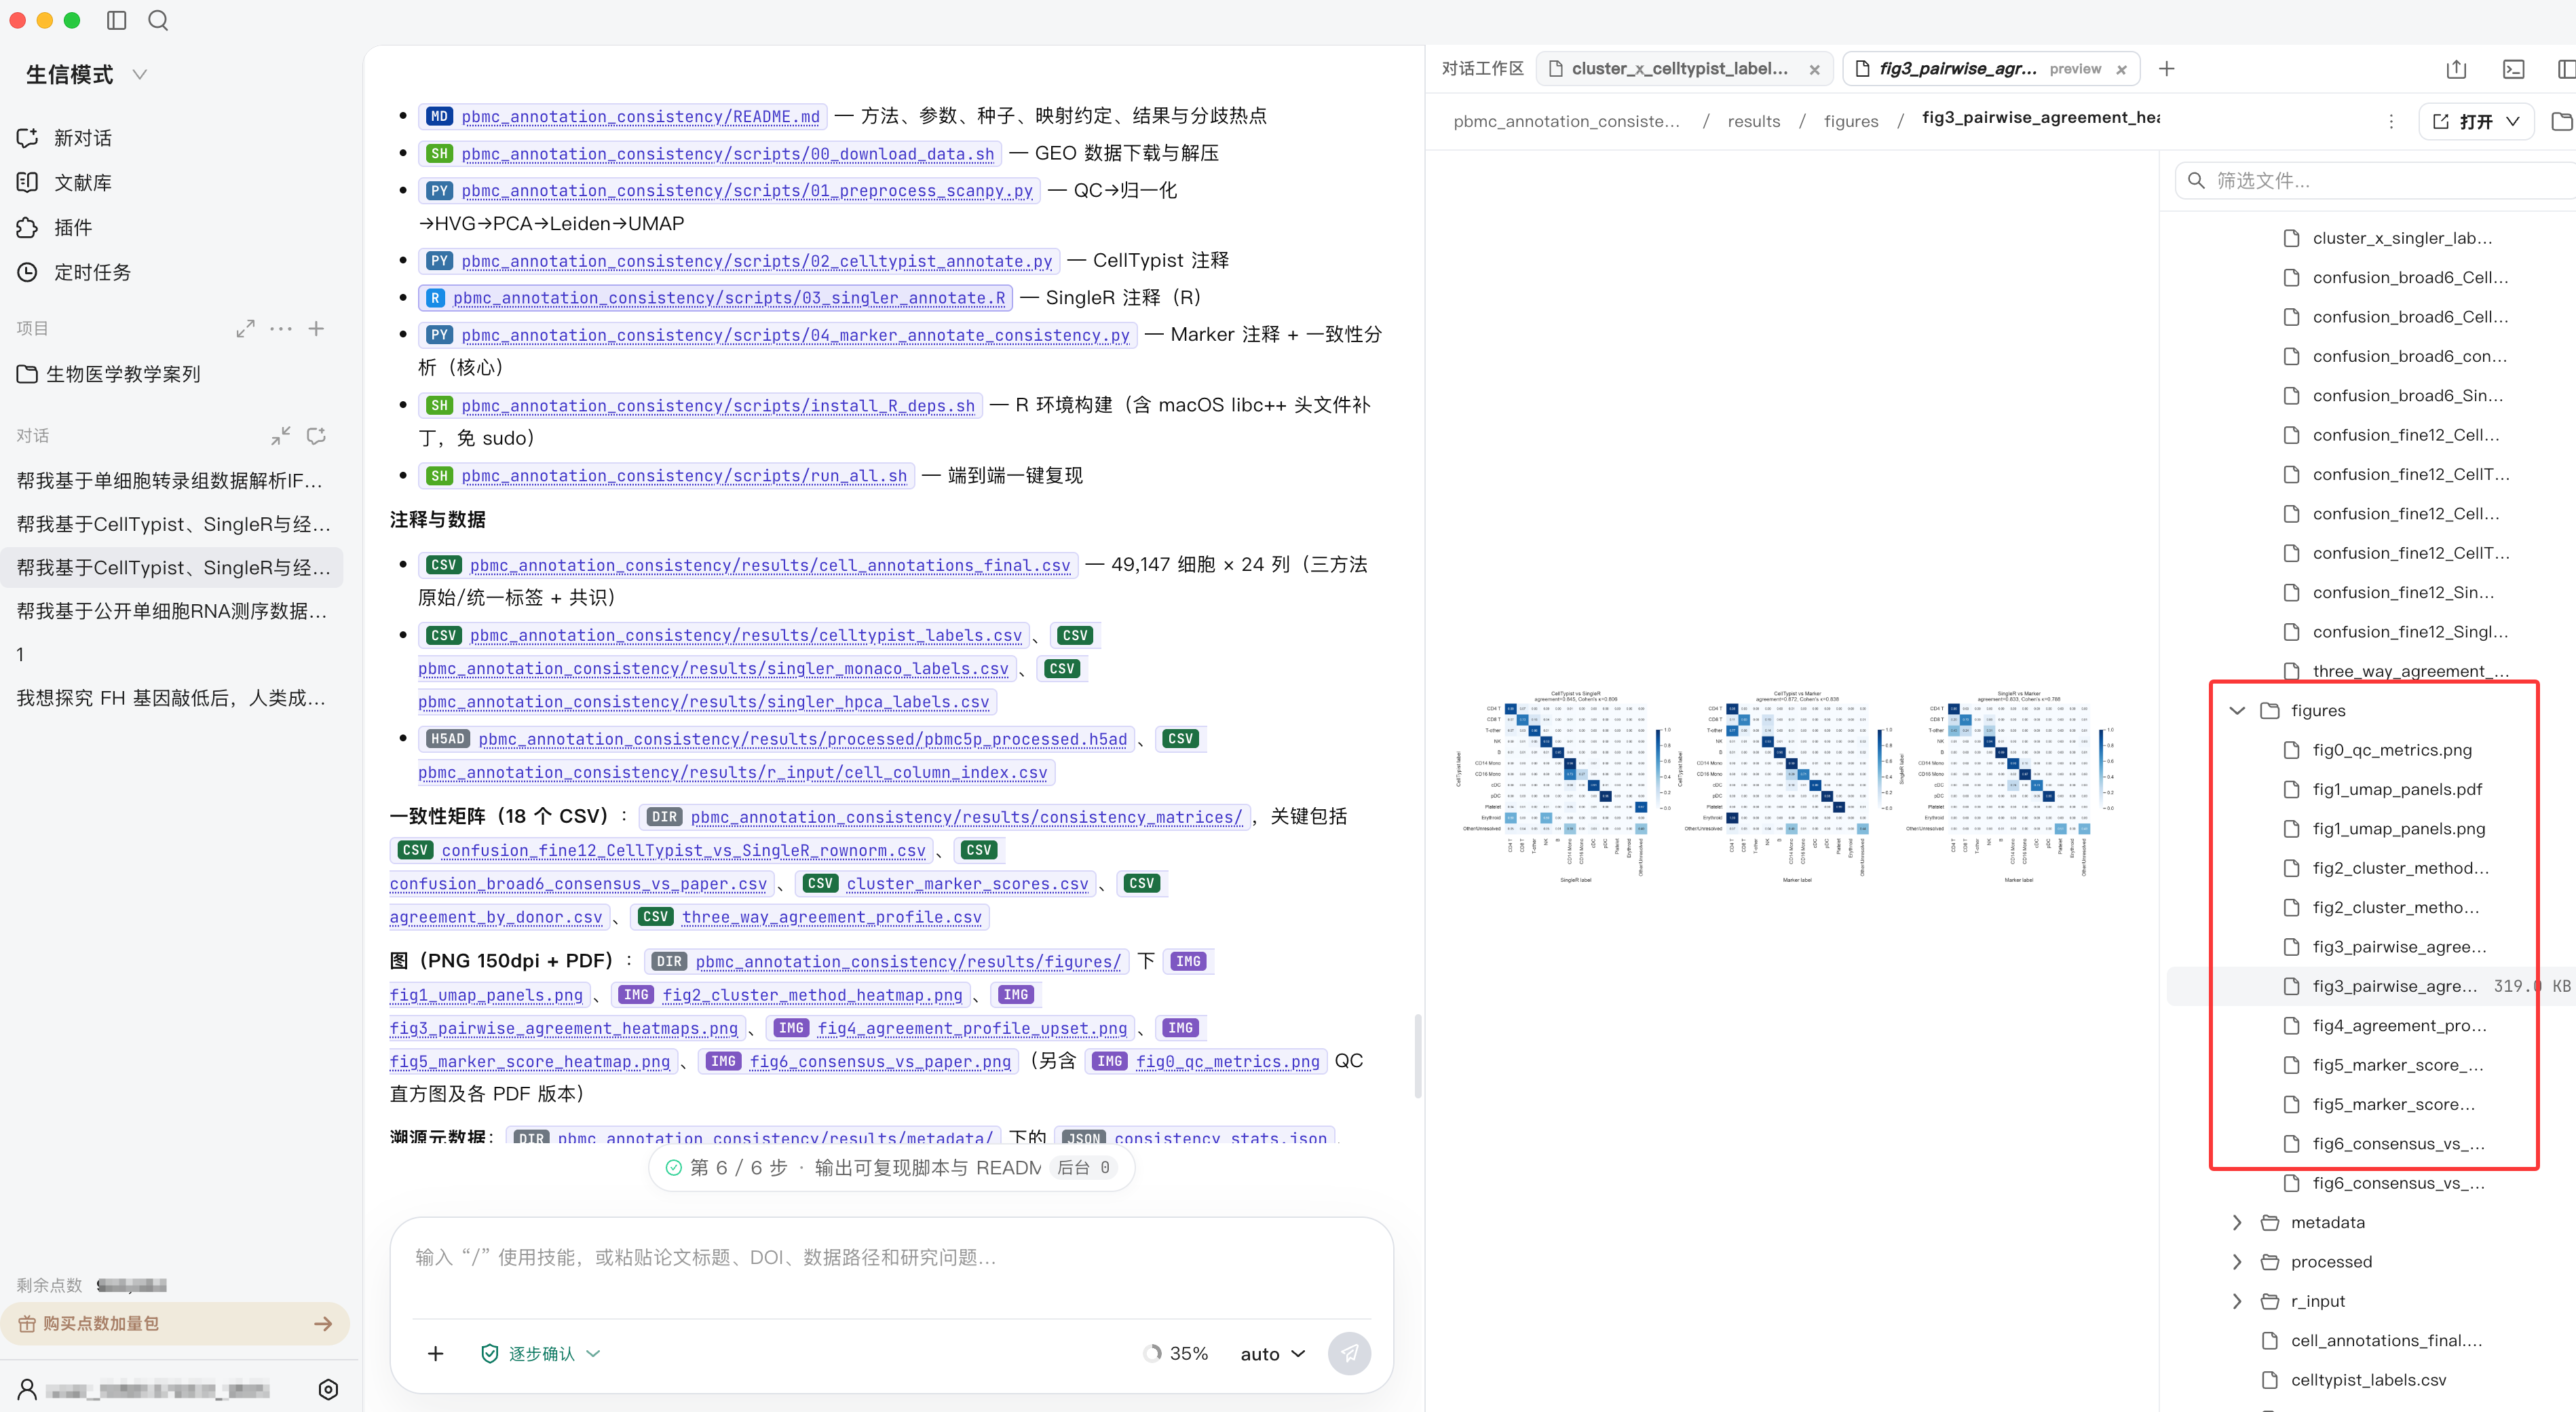
展开 figures 文件夹,点击结果图即可在右侧预览。检查 UMAP 时,应同时比较无监督聚类、Marker 注释和两种自动注释结果,不要只观察某一个面板。
#数据分析与结果
#数据质量控制与聚类
原始数据包含 5,462 个细胞和 33,538 个基因。按照 200 ≤ nGenes ≤ 7,000、线粒体基因比例 ≤ 20% 的标准检查后,未额外剔除细胞;过滤低频基因后保留 15,515 个基因。
标准化后筛选 2,000 个高变基因,使用前 30 个主成分构建 15 近邻图。Leiden resolution 设为 1.0,共获得 15 个细胞簇。
#三种注释方法的 UMAP 对比
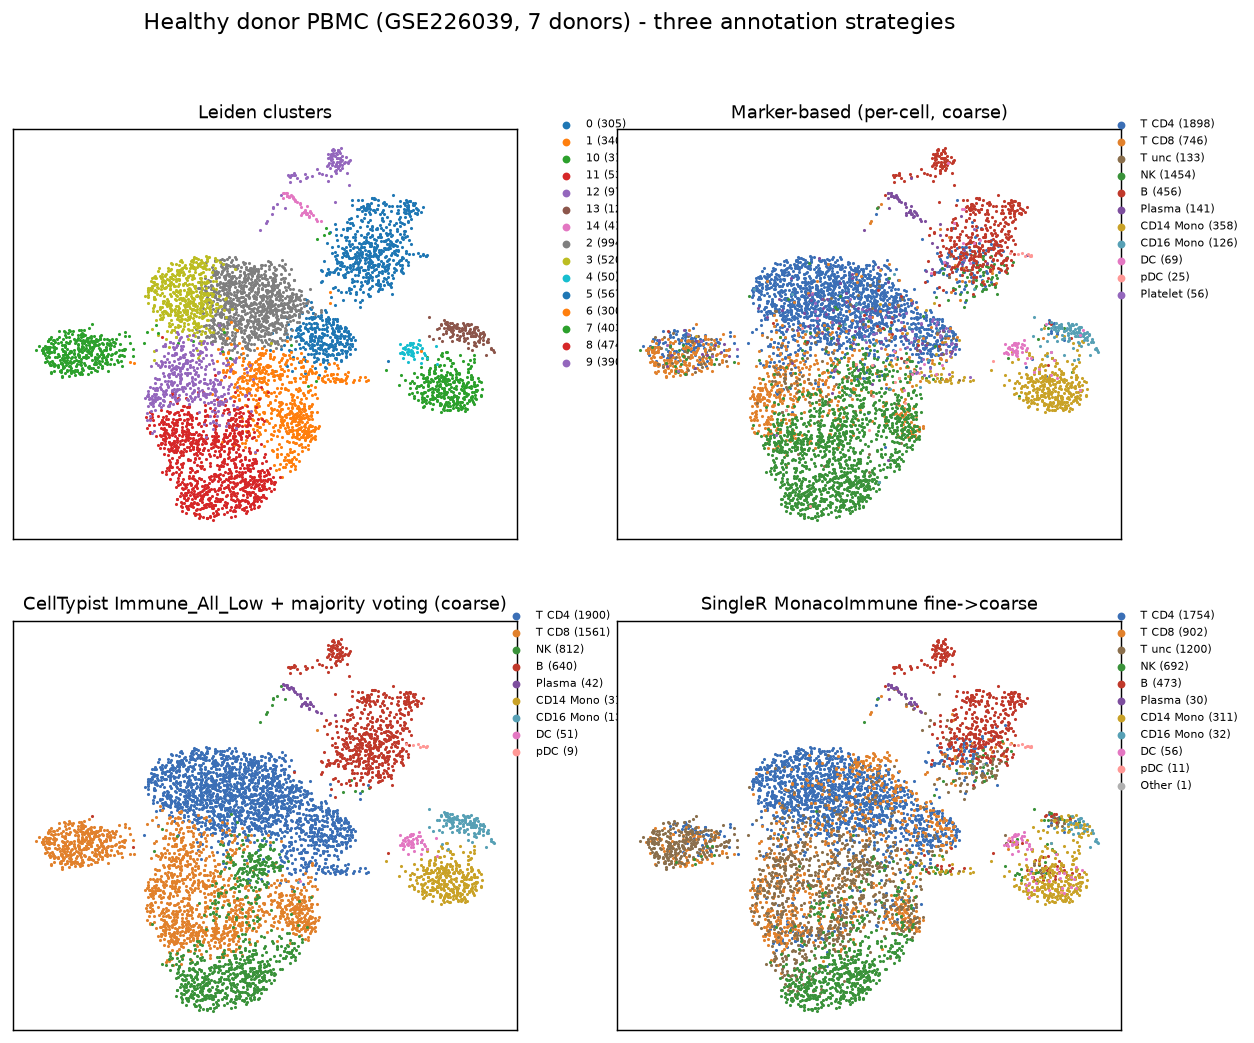
四个 UMAP 分面使用相同的细胞坐标,可直接观察 Leiden 聚类、Marker 注释、CellTypist 注释和 SingleR 注释在转录空间中的对应关系。主要 T、B、NK 和单核细胞群整体位置一致,分歧主要集中在 CD8 T、非常规 T、NK 和 CD16 单核细胞的边界区域。
#两两一致性
在统一粗粒度词表下,三种方法的两两一致率为 55.9%–68.9%,Cohen's κ 为 0.460–0.605,属于中等一致。CellTypist 与 Marker 的结果最接近,一致率为 68.9%,Cohen's κ 为 0.605。
| 注释方法比较 | 一致率 | Cohen's κ | ARI | NMI |
|---|---|---|---|---|
| CellTypist vs SingleR | 58.8% | 0.490 | 0.396 | 0.455 |
| CellTypist vs Marker | 68.9% | 0.605 | 0.435 | 0.495 |
| SingleR vs Marker | 55.9% | 0.460 | 0.345 | 0.385 |
以 Leiden 簇为单位汇总 Marker 标签后,CellTypist 与 Marker 的一致率提高至 81.3%,Cohen's κ 提高至 0.759,说明簇级判断比逐细胞判断更稳定。
#三方共识结果
5,462 个细胞中,2,682 个细胞获得三方完全一致的标签,占 49.1%;1,983 个细胞获得 2-of-3 多数标签,占 36.3%;797 个细胞三方各异,占 14.6%。
| 共识状态 | 细胞数 | 占比 |
|---|---|---|
| 三方一致 | 2,682 | 49.1% |
| 2-of-3 多数 | 1,983 | 36.3% |
| 三方各异 | 797 | 14.6% |
#不同细胞类型的一致性
注释一致性具有明显的细胞类型差异。pDC 和 CD14 Monocyte 的三方一致率分别为 88.9% 和 70.3%,但 pDC 仅有 9 个细胞,应谨慎解释。T CD8、CD16 Monocyte、T unc 和 Platelet 的一致性较低。
| 细胞类型 | 纳入细胞数 | 三方一致率 | 2-of-3 比例 | 三方各异比例 |
|---|---|---|---|---|
| pDC | 9 | 88.9% | 11.1% | 0.0% |
| CD14 Monocyte | 316 | 70.3% | 28.5% | 1.3% |
| Plasma | 42 | 69.0% | 31.0% | 0.0% |
| T CD4 | 1,900 | 65.3% | 26.6% | 8.1% |
| NK | 812 | 64.4% | 30.2% | 5.4% |
| B | 640 | 55.2% | 31.9% | 13.0% |
| DC | 51 | 51.0% | 45.1% | 3.9% |
| CD16 Monocyte | 131 | 19.1% | 67.9% | 13.0% |
| T CD8 | 1,561 | 16.3% | 52.1% | 31.6% |
| T unc | 1,200 | 0.0% | 54.9% | 45.1% |
| Platelet | 56 | 0.0% | 46.4% | 53.6% |
#主要系统性分歧
最大的分歧来自 SingleR Monaco 参考集对非常规 T 细胞的识别。SingleR 将约 1,200 个细胞标为 T unc,其中 739 个被 CellTypist 标为 T CD8,227 个被 CellTypist 标为 NK。这反映了 γδ T、MAIT、CD8 T 和 NK 之间共享的细胞毒性表达程序。
CD16 Monocyte 也是容易混淆的细胞类型。CellTypist 和 Marker 的细胞数接近,而 SingleR Monaco 更容易将其并入 CD14 Monocyte。Platelet 则主要依赖 PPBP、PF4 等 Marker 信号识别,两种参考法未在粗粒度结果中输出该类型。
#测序深度与参考集敏感性
供体测序深度与一致性明显相关。高深度供体的三方一致率为 53.2%–75.9%,而低深度供体为 33.5%–39.9%,说明低基因检出率会降低细胞类型判别稳定性。
SingleR 的参考集选择同样会改变结果。MonacoImmuneData 与 BlueprintEncodeData 两套 SingleR 标签的一致率仅为 59.2%;改用 BlueprintEncodeData 后,CellTypist 与 SingleR 的一致率由 58.8% 提高至 70.6%。因此,参考集选择本身就是需要记录和验证的分析变量。
#结果文件
report/report.md:完整分析报告results/per_cell_labels.csv:三种方法的逐细胞标签、共识标签和共识状态results/consistency_metrics.csv:一致率、Cohen's κ、ARI 和 NMIresults/threeway_summary.csv:三方共识比例汇总results/per_type_consensus.csv:不同细胞类型的共识情况results/systematic_confusions.csv:主要系统性混淆组合results/label_mapping.csv:原始标签到统一词表的映射记录results/adata_processed.h5ad:包含降维、聚类和注释结果的 AnnData 对象figures:案例二结果图scripts/run_all.sh:完整流程入口脚本
#结果总结
本案例对 5,462 个健康人 PBMC 细胞进行了 CellTypist、SingleR 和经典 Marker 三方注释比较。三种方法在粗粒度词表下达到中等一致,49.1% 的细胞三方完全一致,36.3% 获得 2-of-3 多数结果。簇级 CellTypist 与 Marker 一致率达到 81.3%,高于逐细胞比较。分歧主要集中在 CD8 T、非常规 T、NK、CD16 Monocyte 和 Platelet,且会受到测序深度和参考集选择影响。
#使用建议
- 优先使用簇级共识确定主要细胞类型,再单独标记簇内低置信度细胞。
- 对 CD8 T、NK、γδ T 和 MAIT 等共享细胞毒程序的细胞,应结合多个阳性和阴性 Marker 判断。
- 关注 CD16 Monocyte 或 Platelet 时,不应只依赖参考型自动注释工具。
- 正式报告结果时,应同时提供参考集、模型版本、标签映射规则和共识比例。
- 低深度数据应使用更粗的标签粒度,并结合 CITE-seq、TCR-seq 或其他正交证据验证稀有类型。