
单细胞 RNA-seq 分析实战:PBMC 3k 免疫细胞图谱(Scanpy)
用科搭 Codar 生信模式分析 10x Genomics PBMC 3k 公开数据:质量控制、高变基因、PCA、Leiden 聚类、UMAP、细胞类型注释与 Marker 验证,附完整操作步骤和结果图。
#案例目标
使用公开的 10x Genomics PBMC 3k 单细胞 RNA 测序数据,完成质量控制、特征选择、降维聚类、细胞类型注释和 Marker 验证,构建可复现的健康人外周血免疫细胞图谱。
#研究背景
外周血单个核细胞(PBMC)包含 T 细胞、B 细胞、NK 细胞、单核细胞和树突状细胞等免疫细胞。单细胞 RNA 测序可以同时观察不同细胞群的转录特征,是学习单细胞数据分析和免疫细胞注释的经典场景。
本案例使用数据量适中的 PBMC 3k 数据集,帮助用户快速跑通从原始表达矩阵到免疫图谱的完整流程。
#研究方法
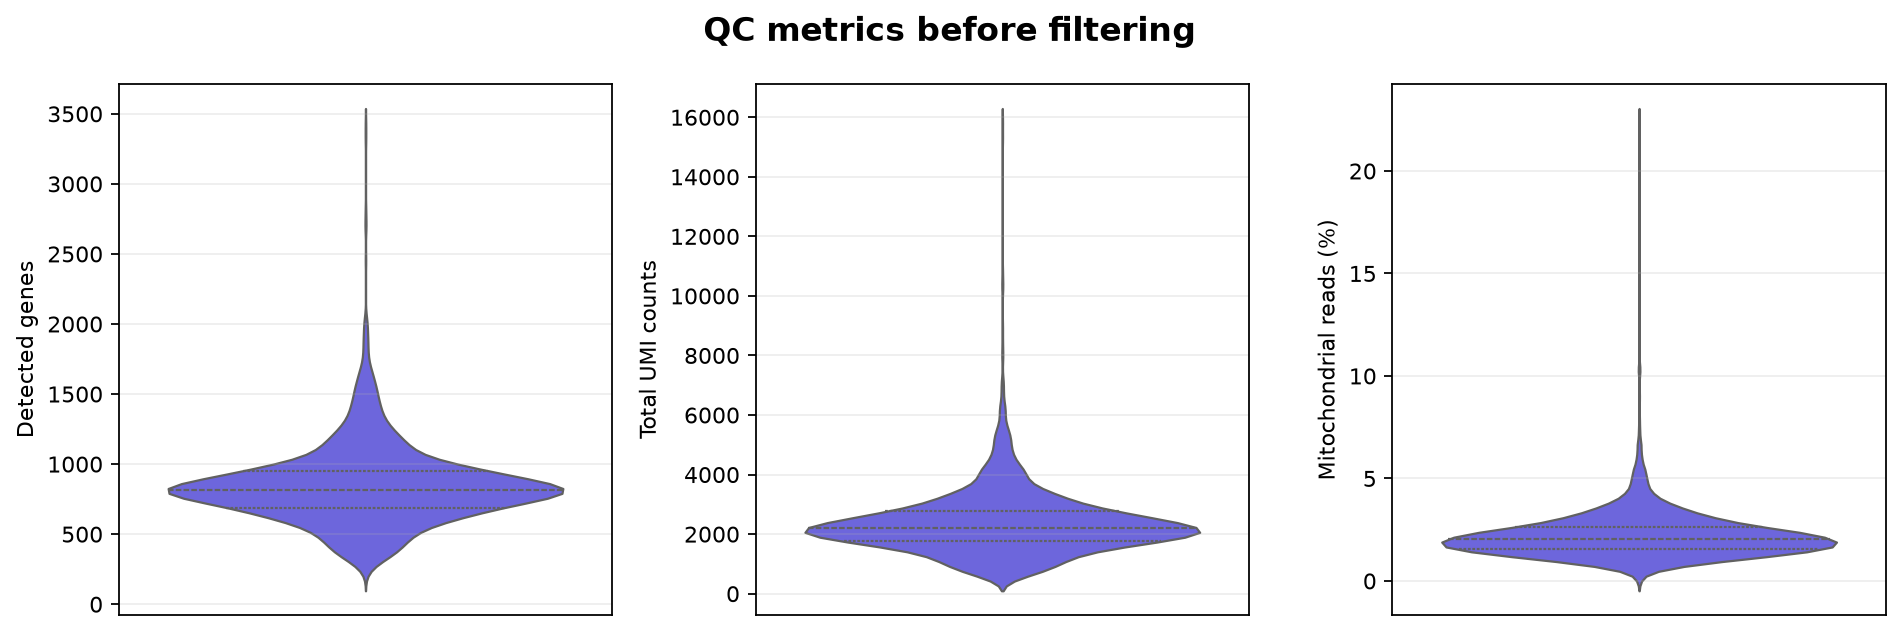
- 使用 Scanpy 读取 10x 表达矩阵并计算每个细胞的基因数、UMI 数和线粒体基因比例。
- 按基因数 200–2,500、线粒体基因比例低于 20% 的条件过滤低质量细胞和潜在双细胞。
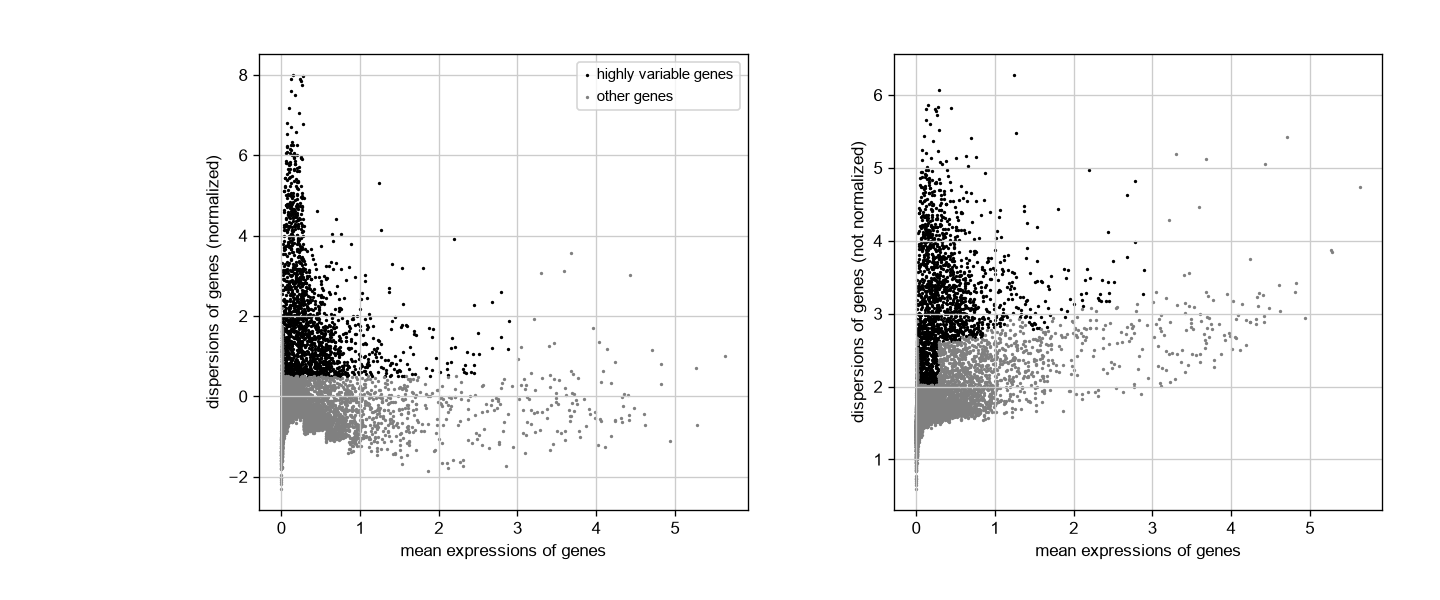
- 使用 CPM 标准化和 log1p 转换,并筛选高变基因。
- 对高变基因进行 PCA,使用前 30 个主成分构建邻居图。
- 使用 Leiden 算法聚类,并通过 UMAP 展示细胞分布。
- 根据经典 Marker 的表达模式完成细胞类型注释和交叉检查。
#研究目标
- 获得通过质量控制的高质量 PBMC 单细胞表达矩阵。
- 识别主要转录细胞群并完成免疫细胞类型注释。
- 使用经典 Marker 验证注释结果。
- 统计各免疫细胞类型的数量和比例。
- 输出可继续分析的 AnnData 对象、结果表、图件和脚本。
#拟解决的关键问题
- 原始 PBMC 数据经过质量控制后可保留多少细胞和基因?
- 无监督聚类能否分离主要免疫细胞群?
- 经典 Marker 的表达是否支持细胞类型注释?
- 各类免疫细胞在该样本中的组成比例如何?
#分析流程
- 下载并读取 10x PBMC 3k 表达矩阵。
- 计算质量控制指标并过滤低质量细胞。
- 完成标准化、log1p 转换和高变基因筛选。
- 运行 PCA、邻居图、Leiden 聚类和 UMAP。
- 检查经典免疫 Marker 并注释细胞类型。
- 绘制 Marker 和细胞比例图。
- 导出 AnnData 对象、结果表、图件和分析报告。
#数据准备
#数据来源
- 数据集:10x Genomics PBMC 3k 示例数据
- 样本:单一健康供体的外周血单个核细胞
- 原始规模:2,700 个细胞、32,738 个基因
- 参考基因组:hg19(GRCh37)
- 数据格式:10x Matrix Market 矩阵、基因和细胞条形码文件
#用户操作教程
#第一步:创建任务
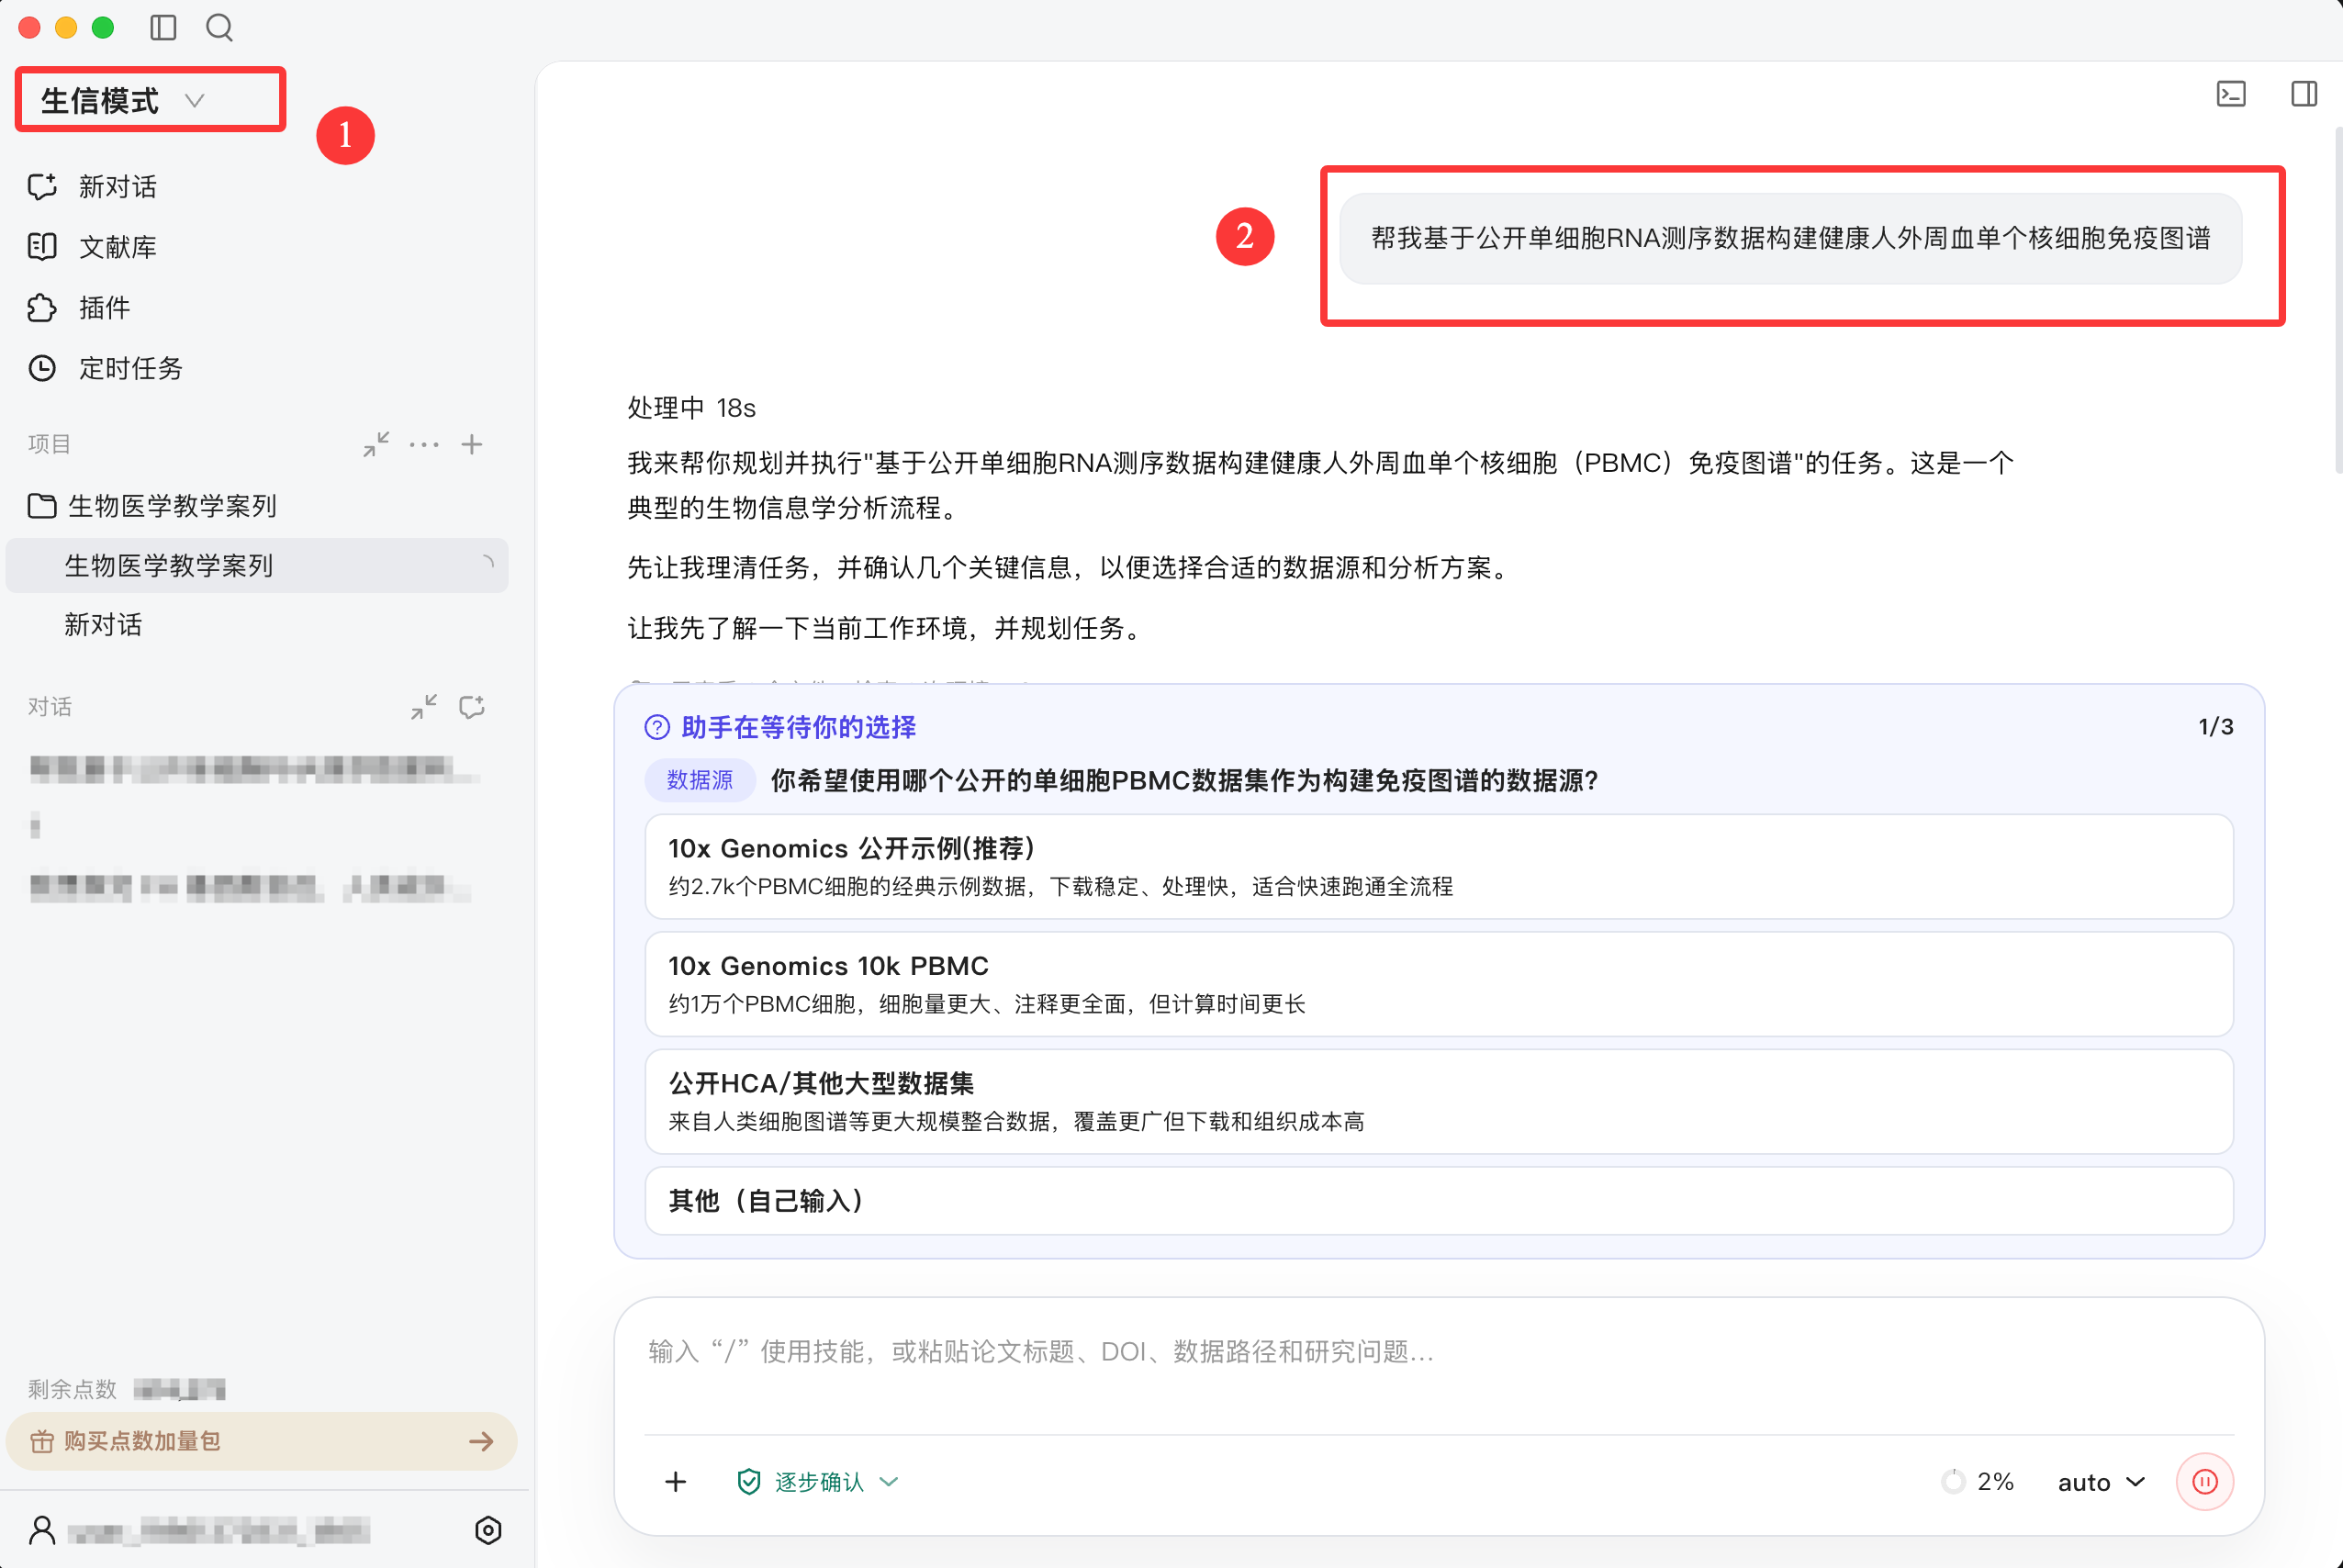
- 打开 Codar,在左上角选择 生信模式。
- 点击 新对话,输入任务目标:
帮我基于公开单细胞 RNA 测序数据构建健康人外周血单个核细胞免疫图谱。
- 发送任务后,Codar 会梳理需求并确认分析方案。
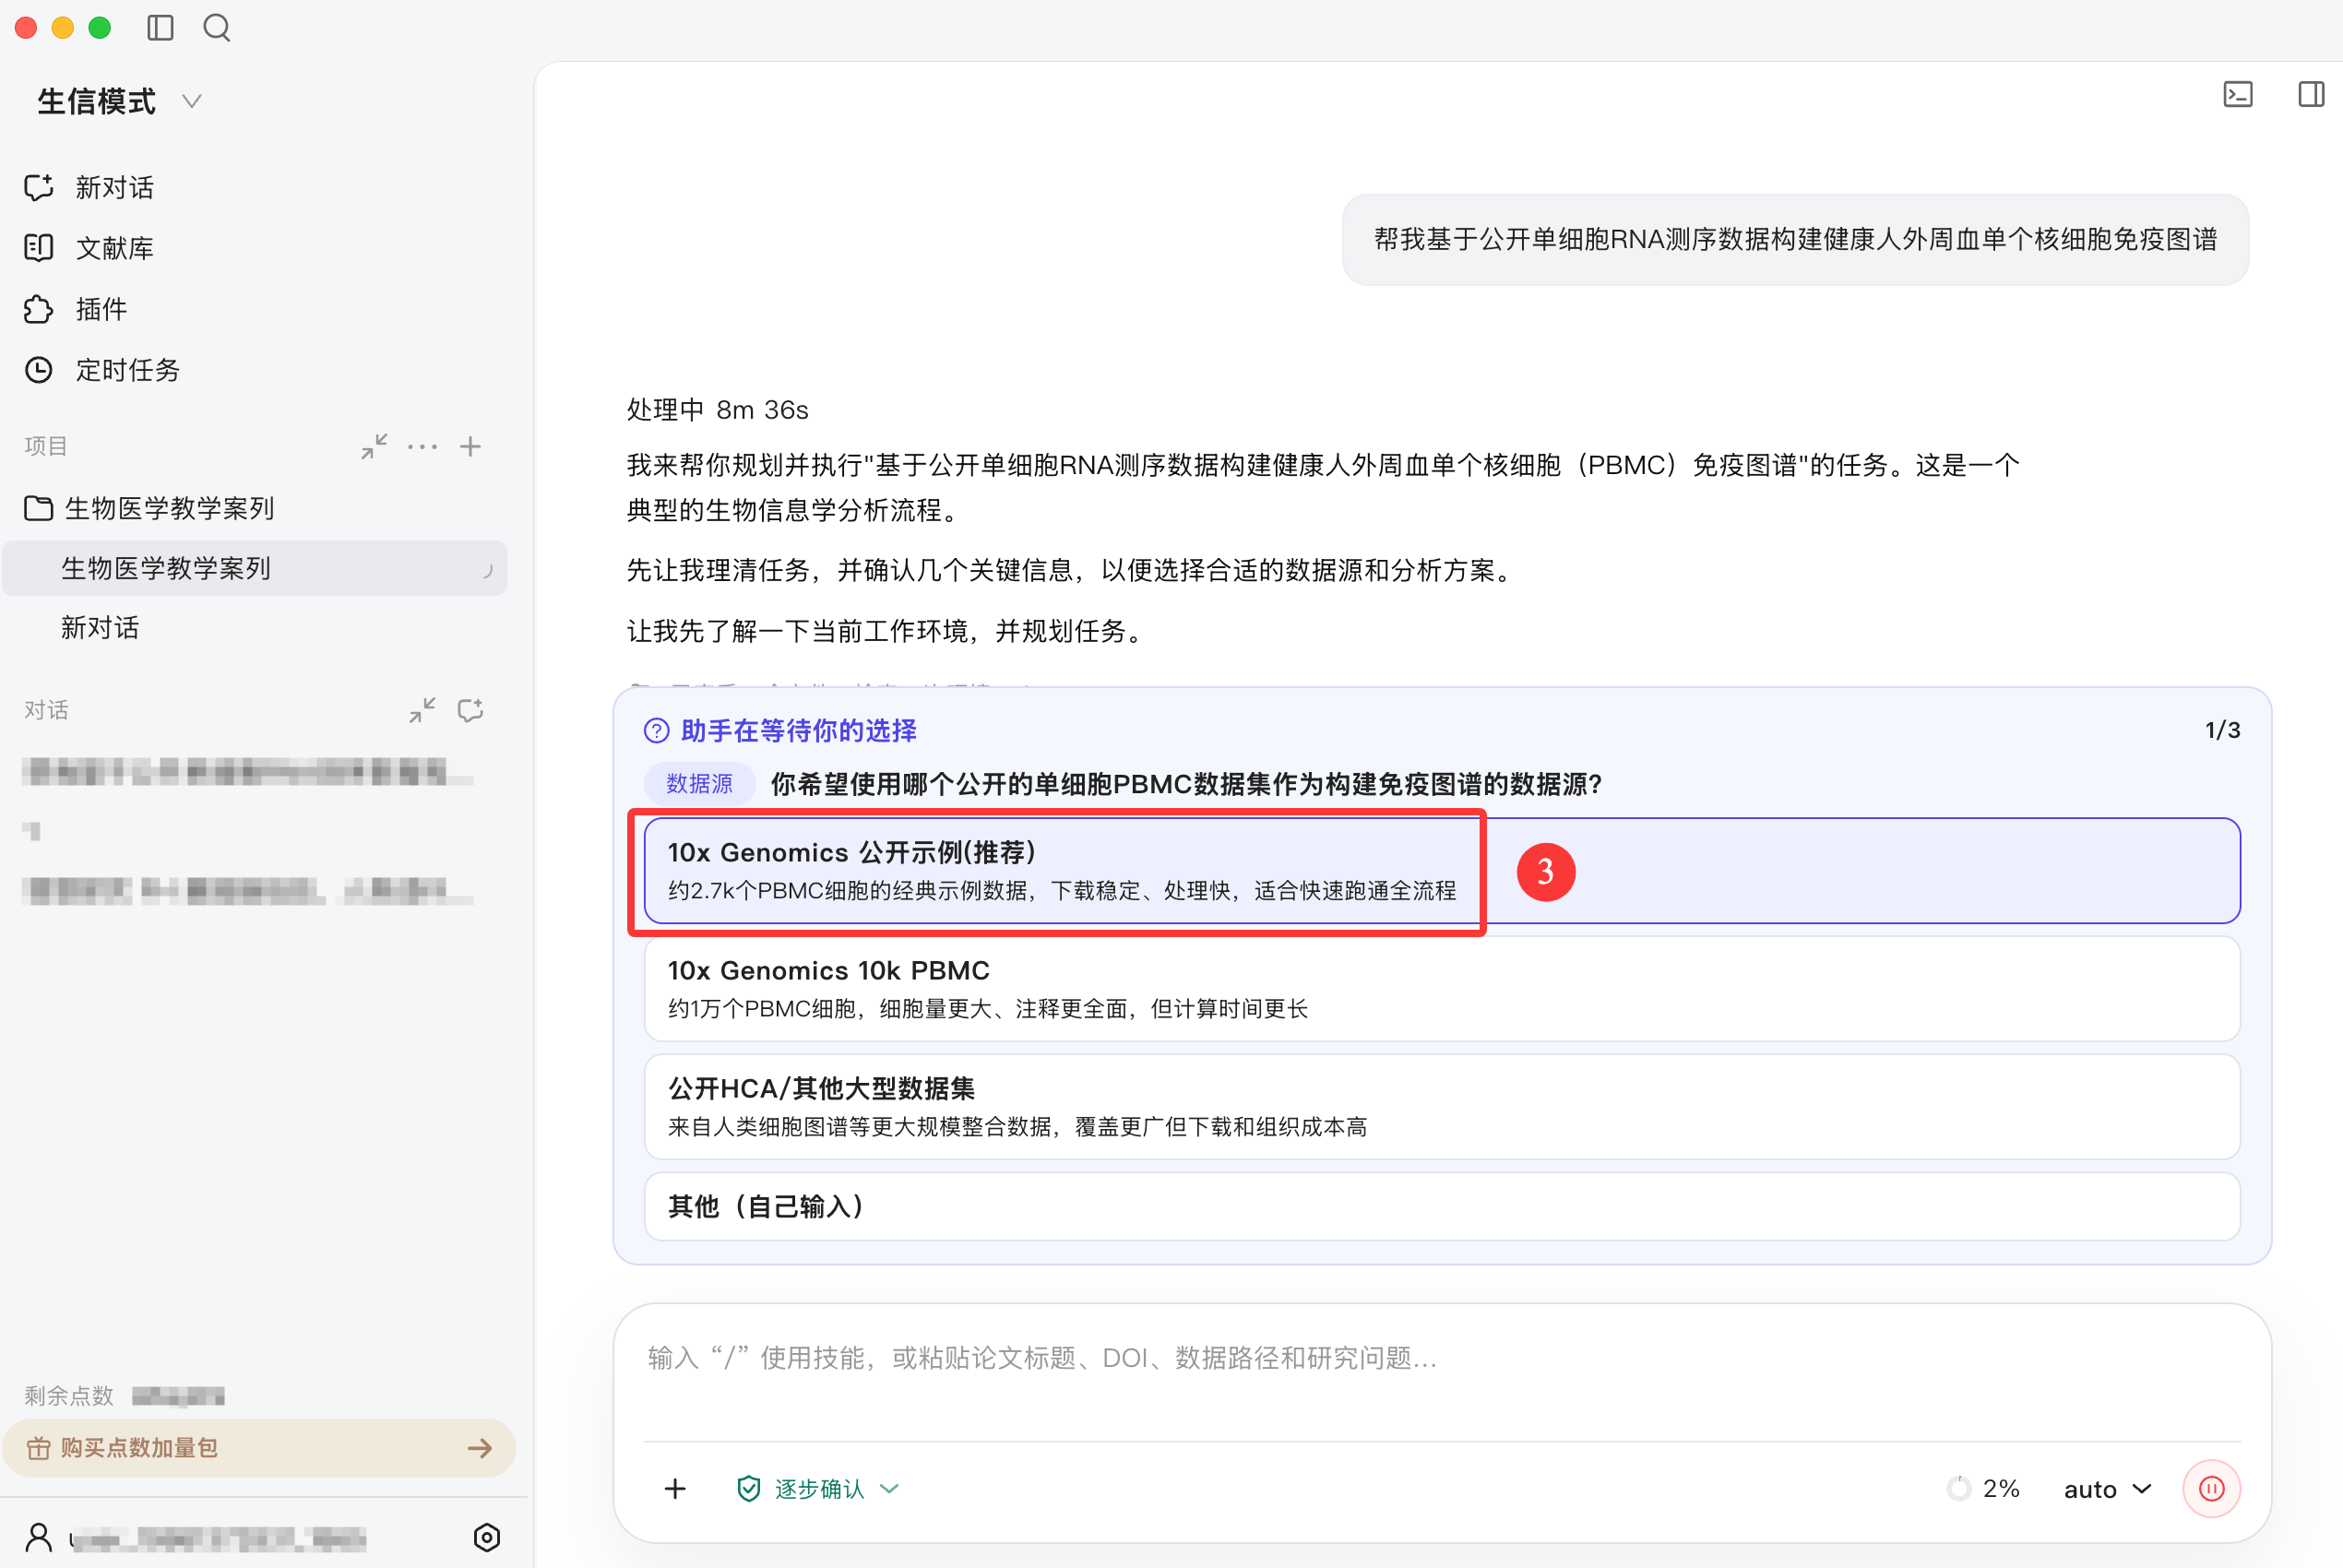
#第二步:选择数据源
在“数据源”问题中选择 10x Genomics 公开示例(推荐)。该数据集规模较小,适合快速跑通完整流程。已有指定数据时,可选择“其他”并补充本地路径或下载地址。
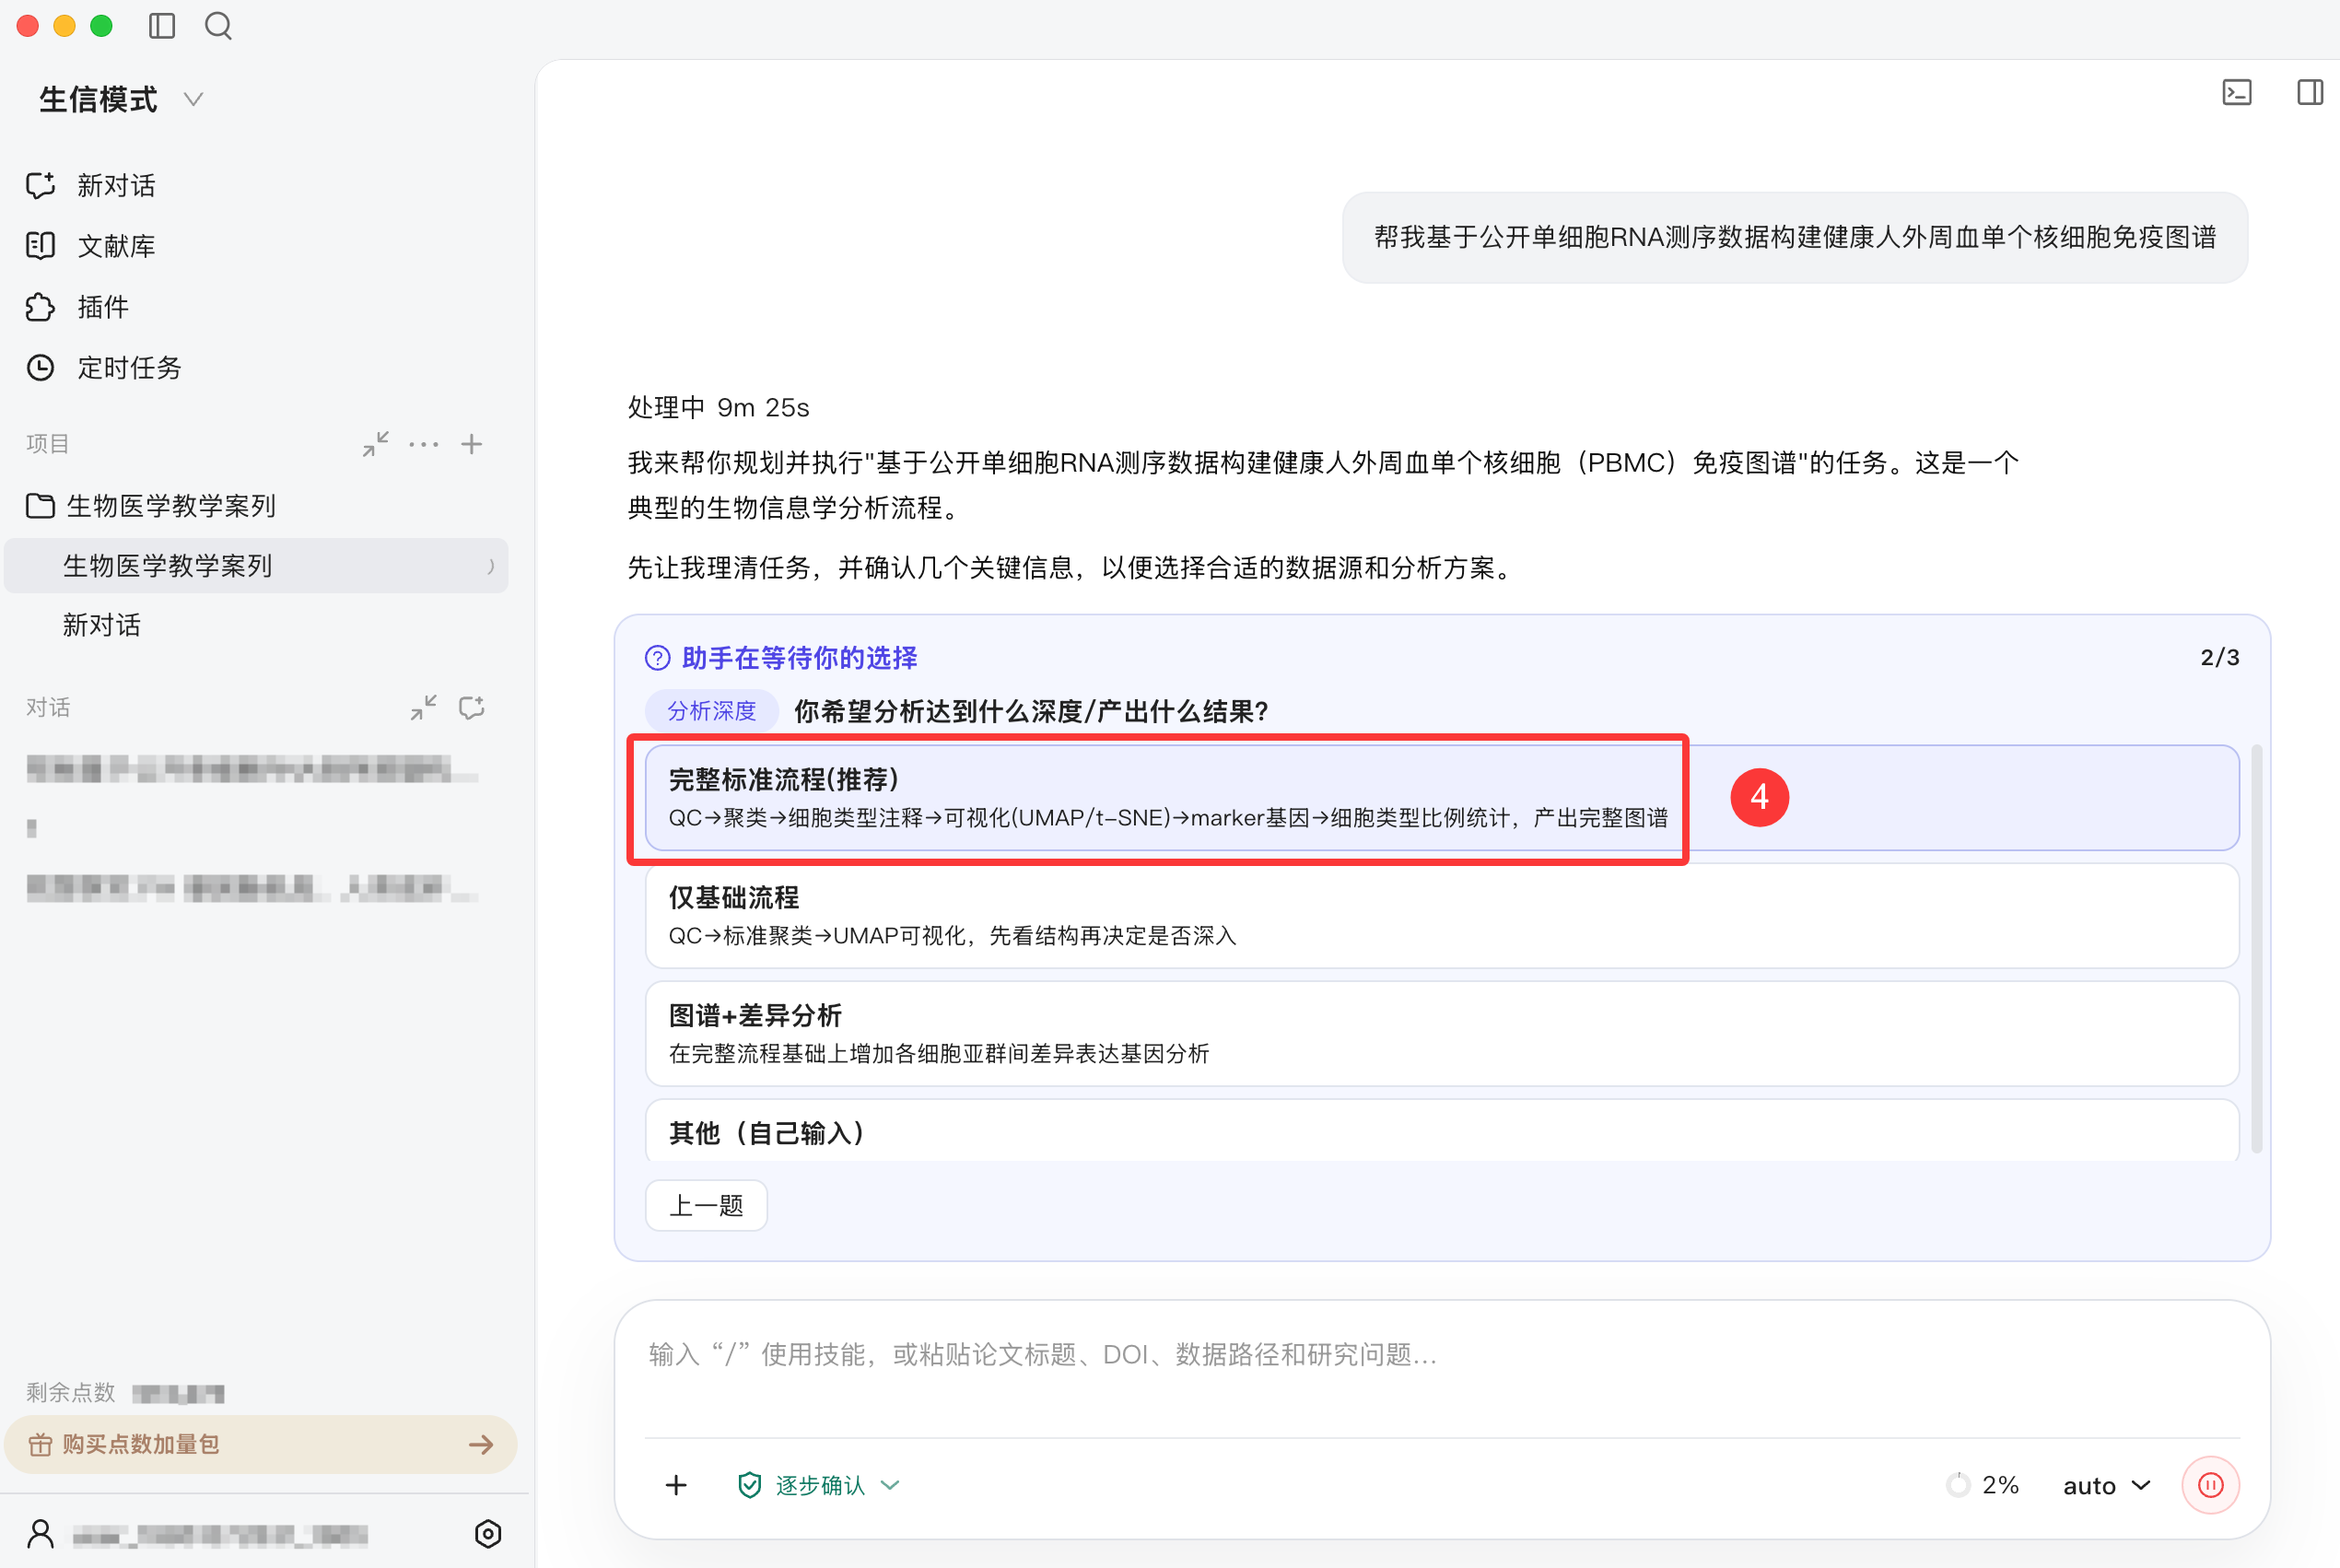
#第三步:选择分析深度
选择 完整标准流程(推荐),Codar 将执行质量控制、标准化、特征选择、降维聚类、细胞注释、Marker 验证和结果导出。
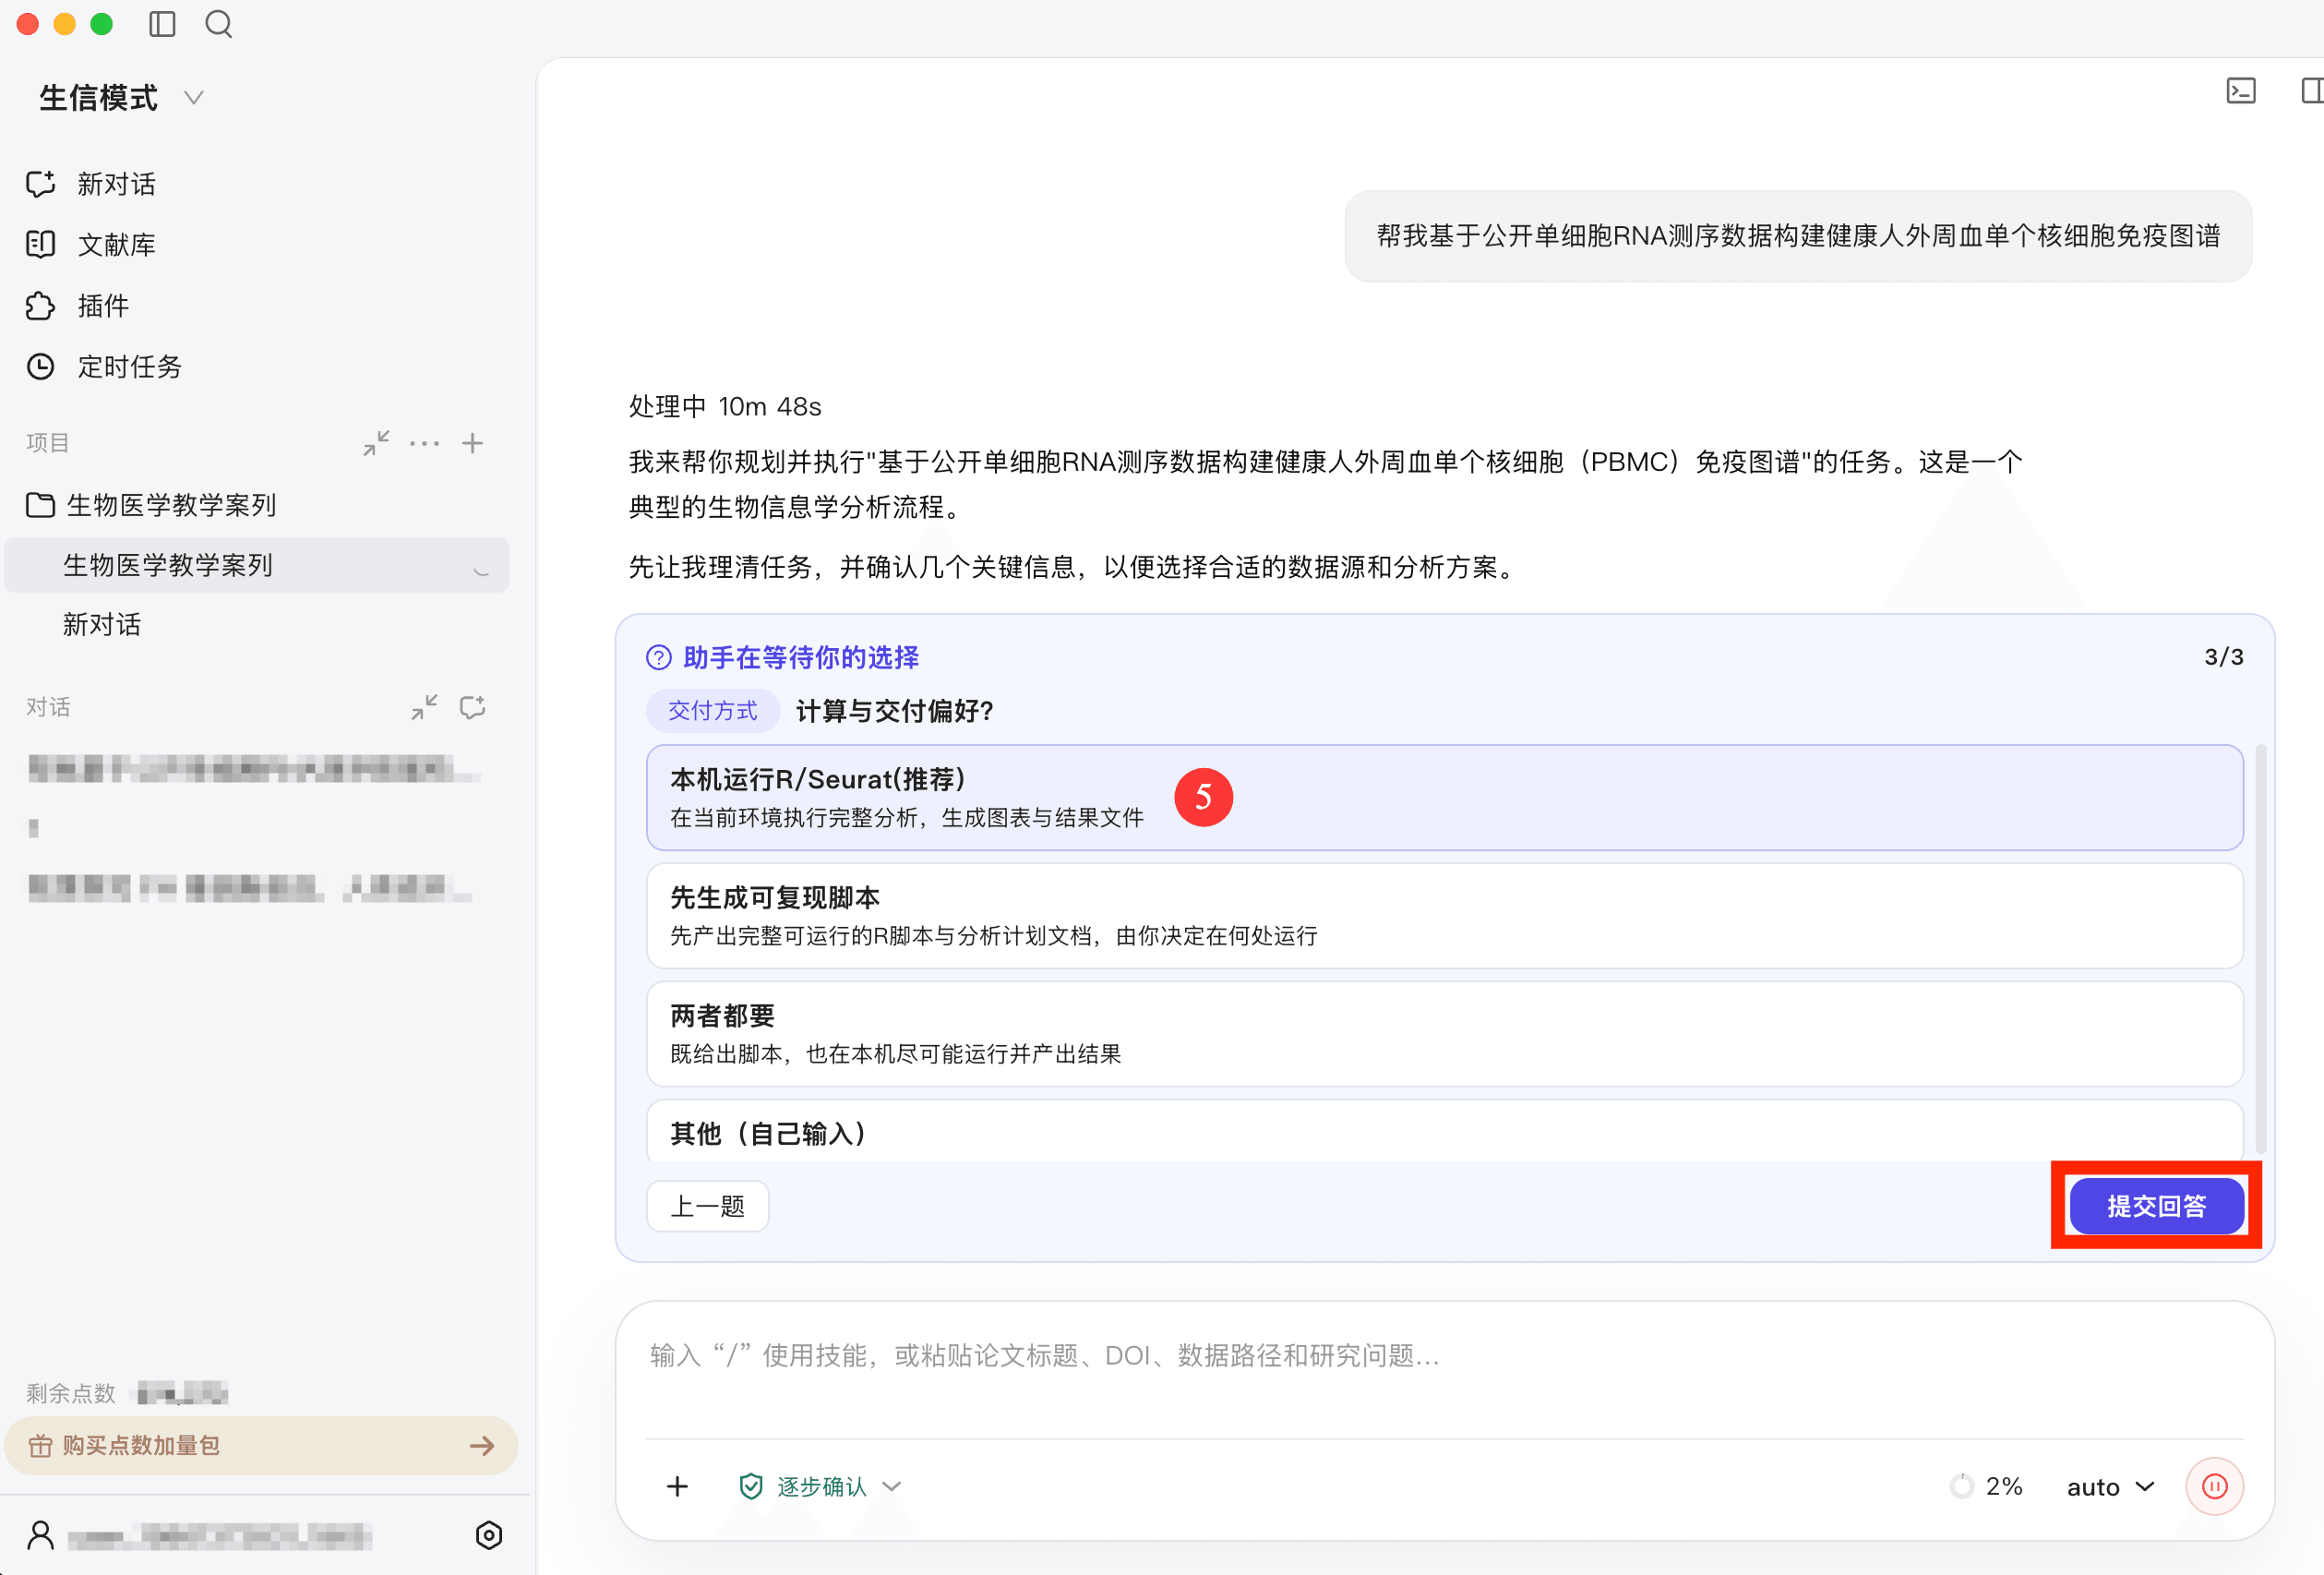
#第四步:选择计算与交付方式
选择本机运行或先生成脚本,再点击 提交回答。本案例最终使用 Python Scanpy 完成计算,并同时保留脚本和结果文件。
#第五步:查看任务计划
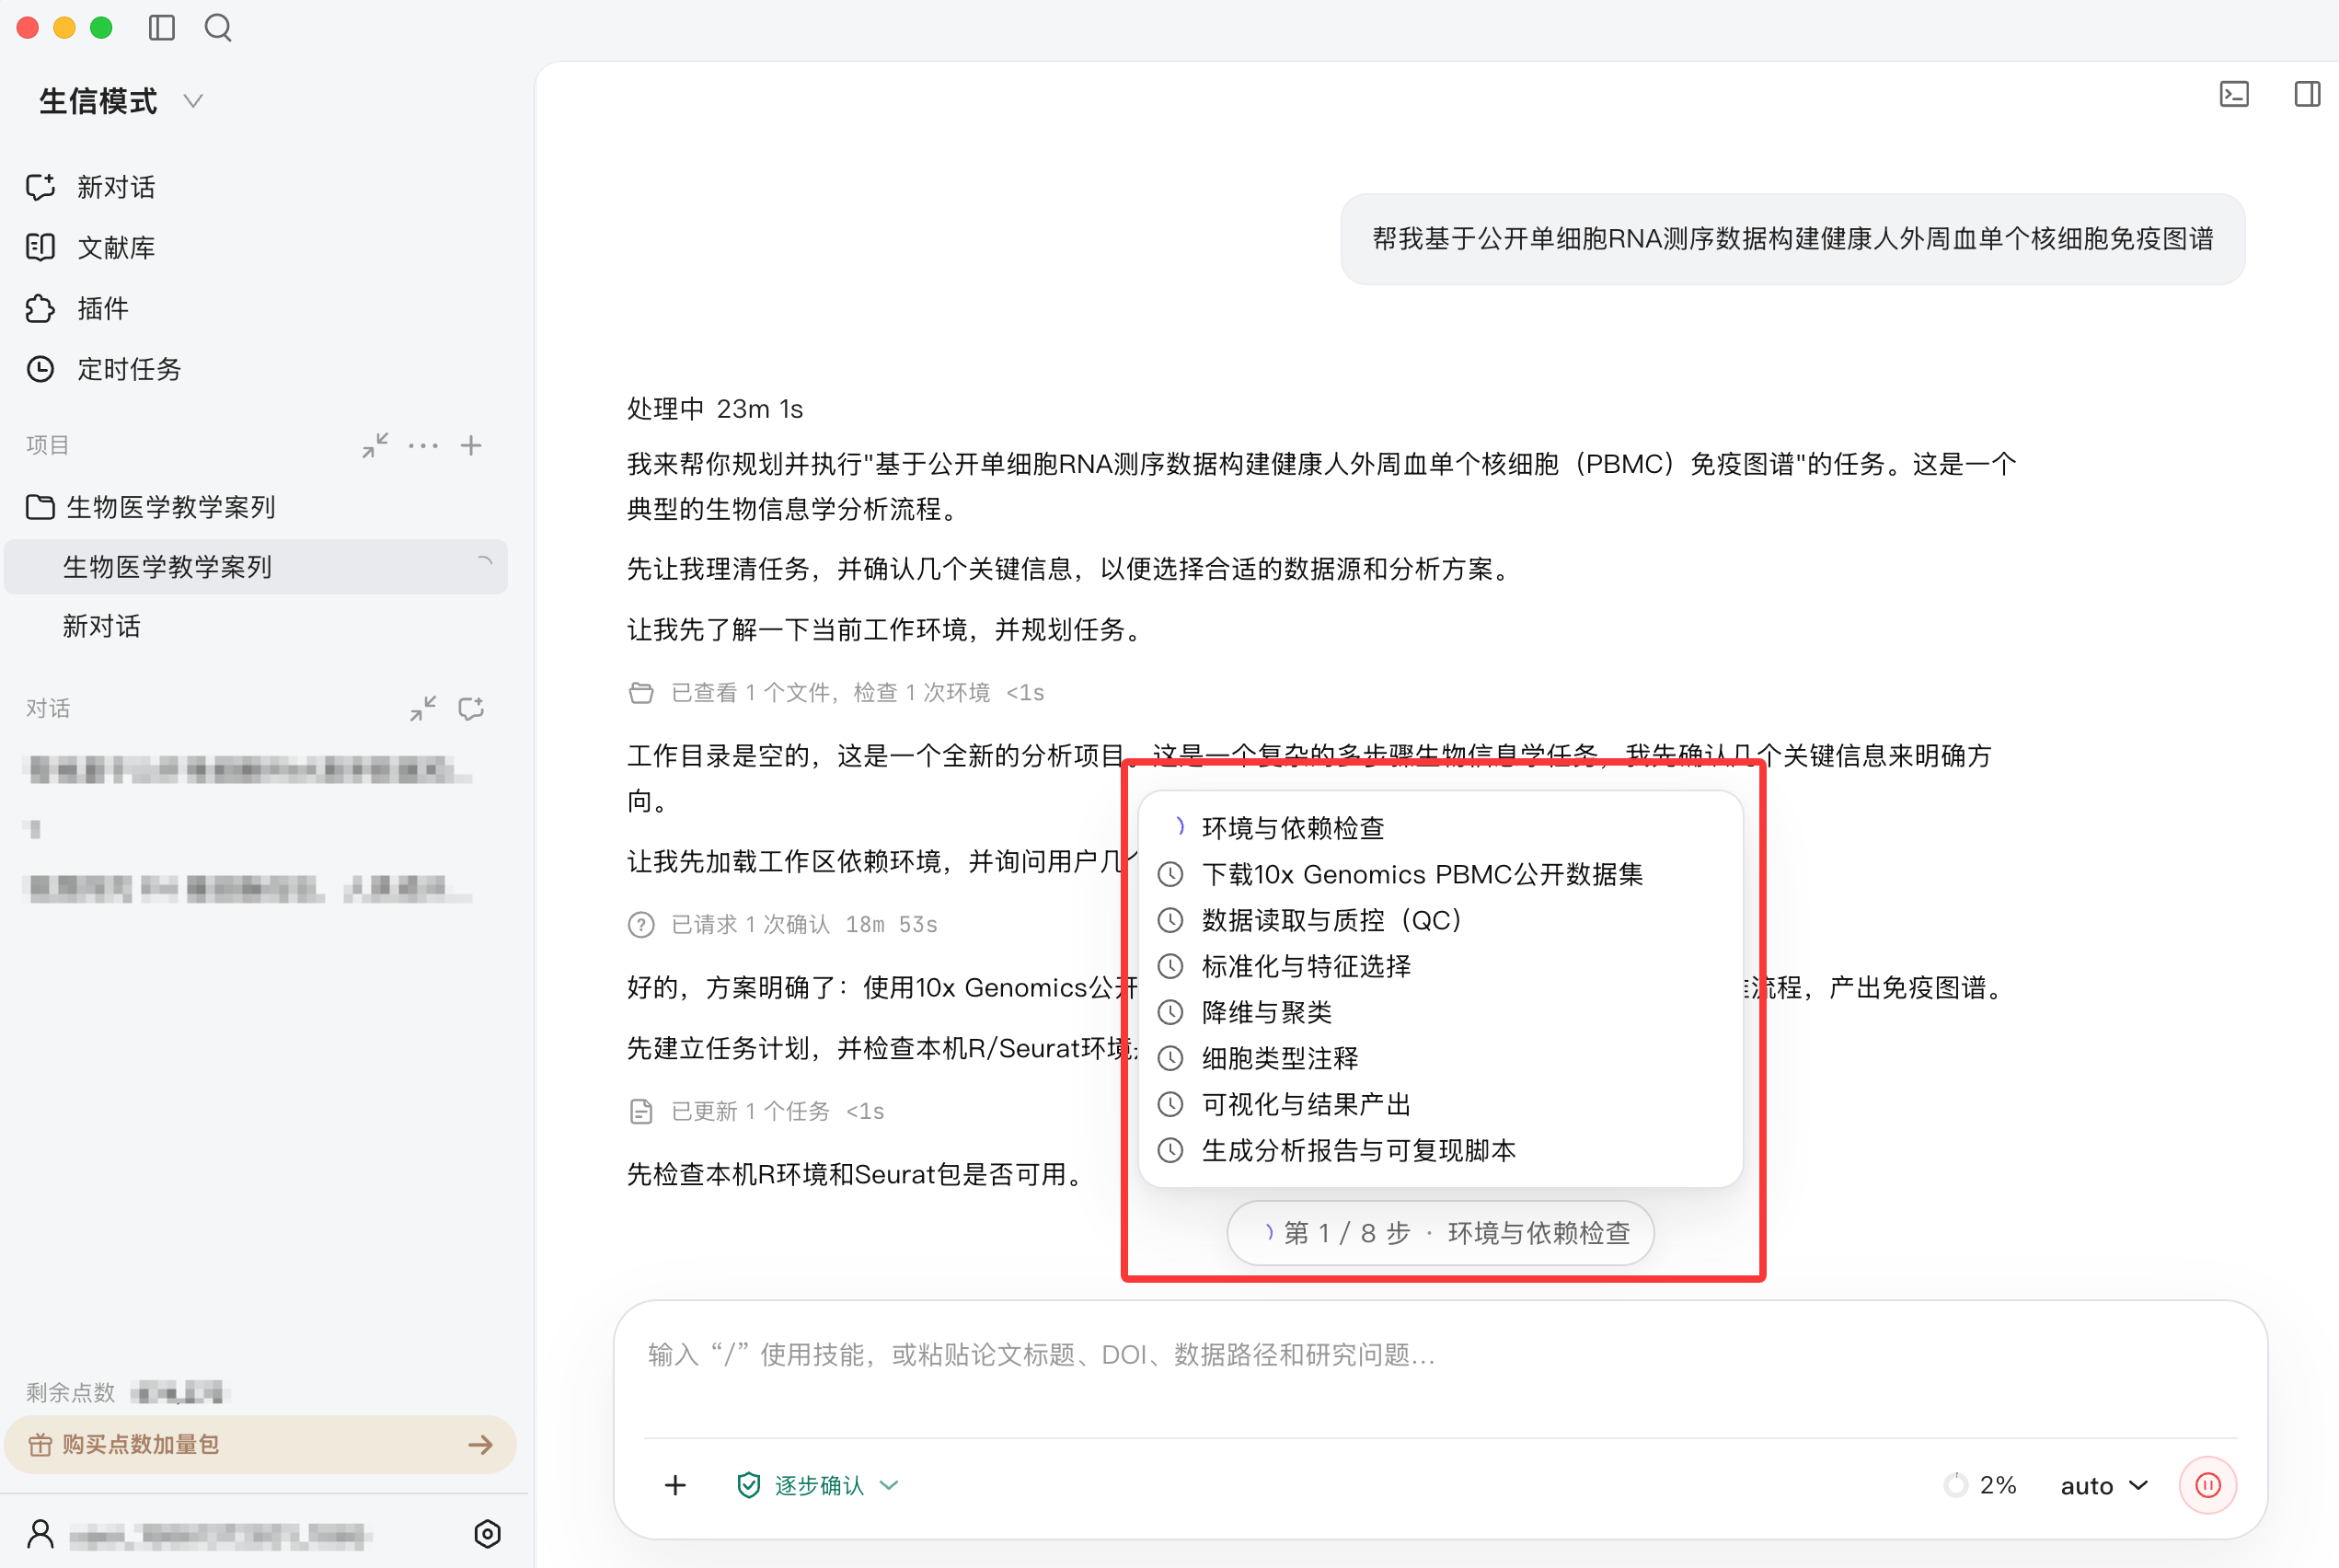
提交后,Codar 会生成任务计划并逐步执行。界面底部会显示当前步骤和整体进度;需要安装依赖或访问文件时,根据提示确认即可。
#第六步:查看结果产出
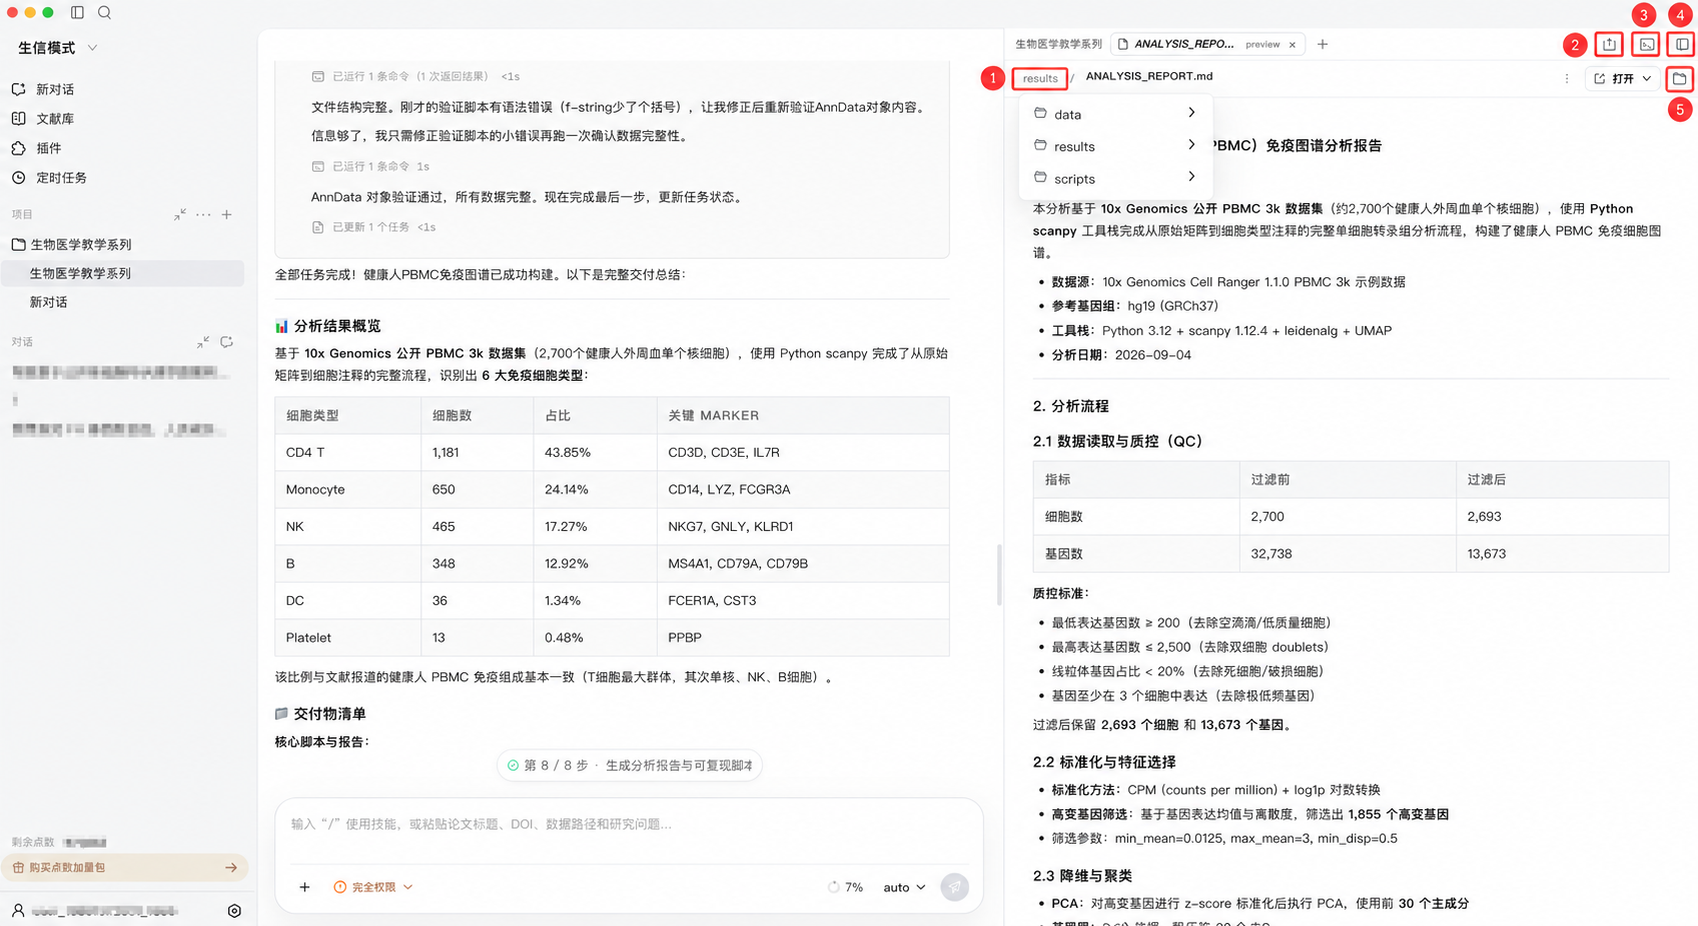
任务完成后,报告、数据、图表和脚本会显示在右侧结果产出区。点击文件可直接预览,也可以导出整个会话。
#数据分析与结果
#数据质量控制
原始矩阵包含 2,700 个细胞和 32,738 个基因。过滤低质量细胞、潜在双细胞和低频基因后,保留 2,693 个细胞和 13,673 个基因,细胞保留率为 99.7%。
#标准化与高变基因筛选
表达矩阵经过总量标准化和 log1p 转换后,共筛选出 1,855 个高变基因。高变基因保留了细胞间差异较大的表达信号,用于后续降维和聚类。
#PCA 降维
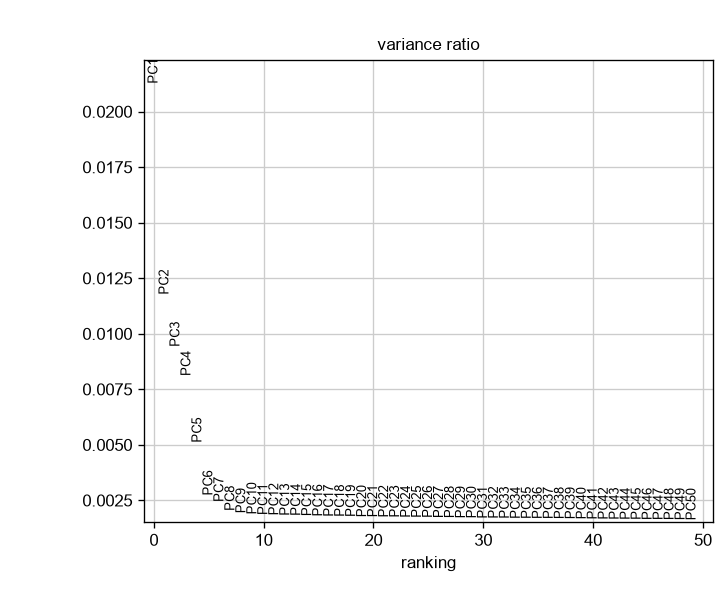
对高变基因进行标准化和 PCA。前几个主成分贡献了主要变异,后续分析使用前 30 个主成分构建细胞邻居图。
#Leiden 聚类
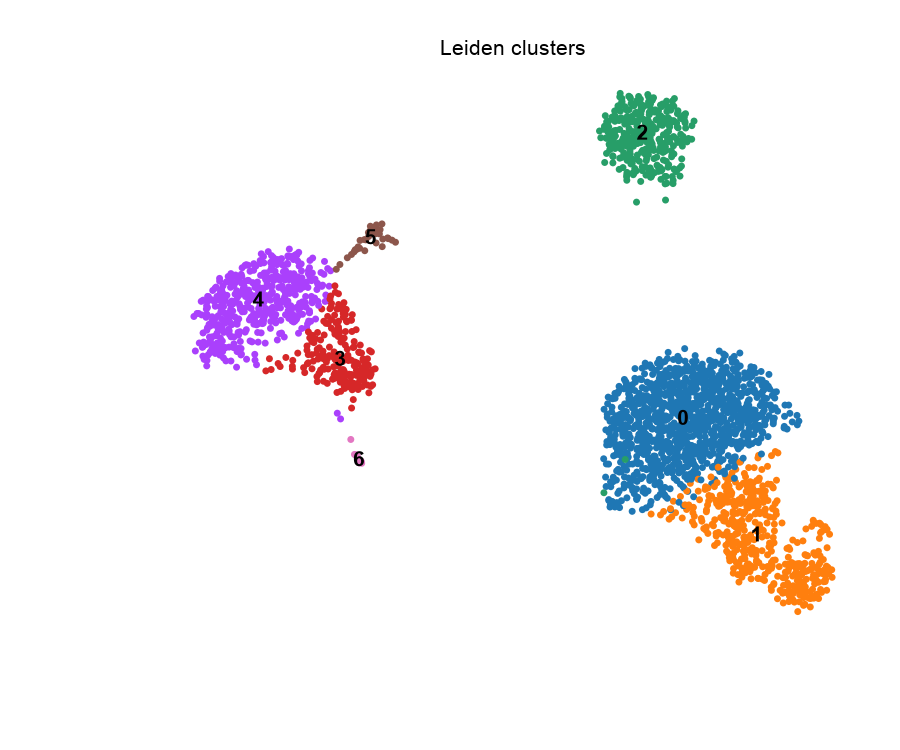
使用 10 个近邻和 Leiden resolution 0.5 对细胞聚类,共识别出 7 个转录细胞群。UMAP 显示主要细胞群之间具有清晰分离,小群体仍保持独立结构。
#细胞类型注释
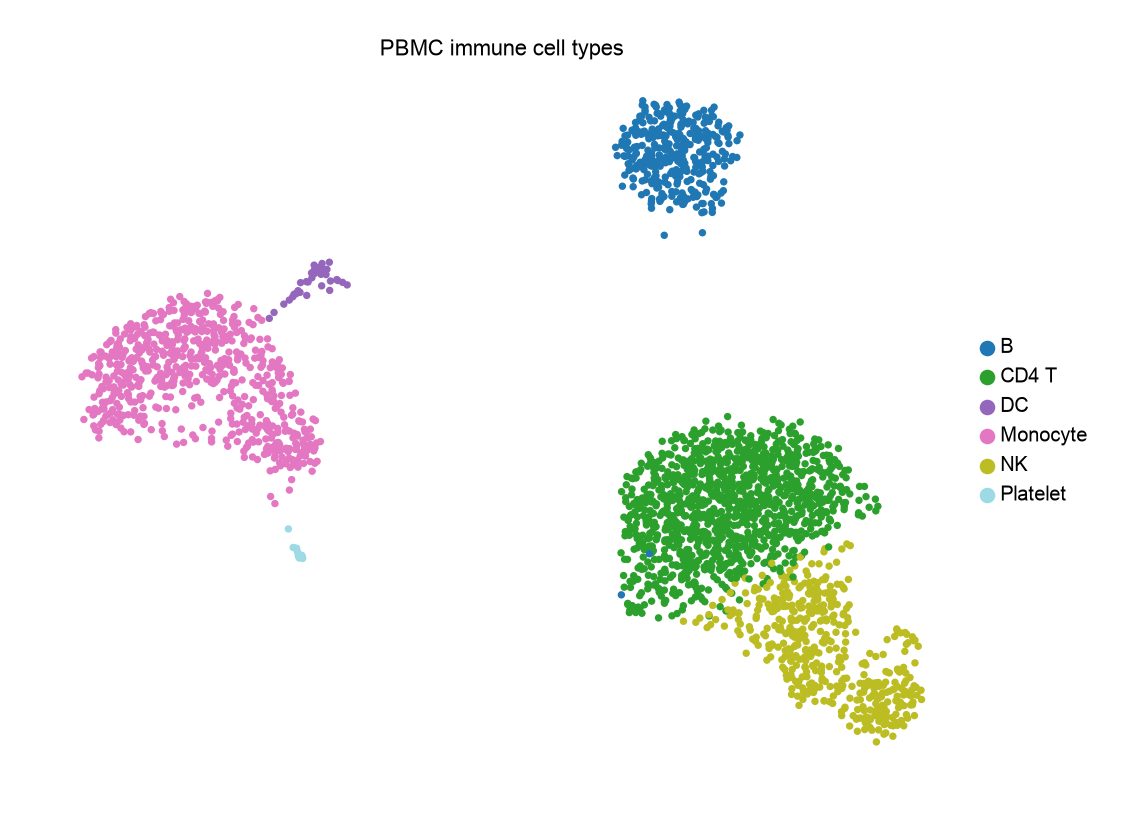
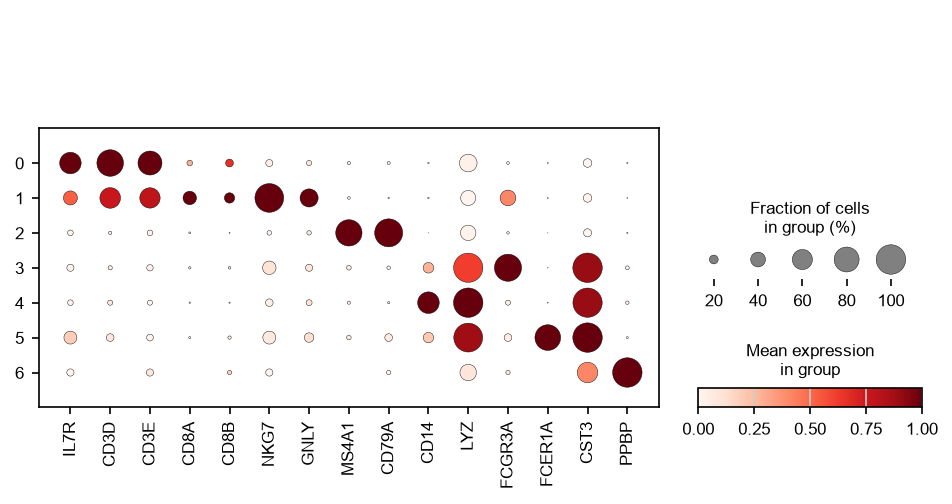
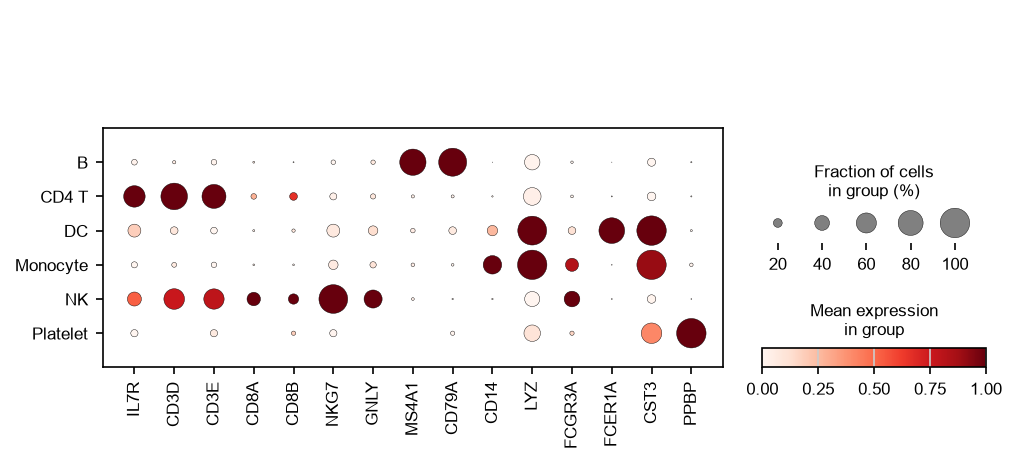
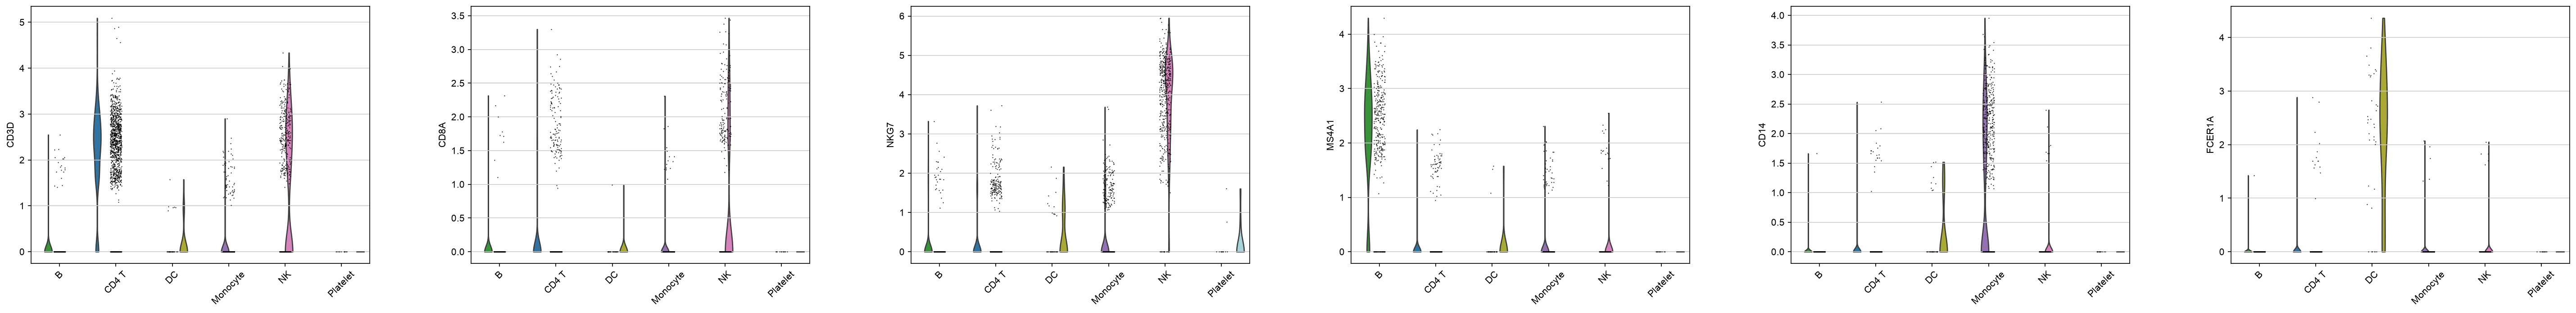
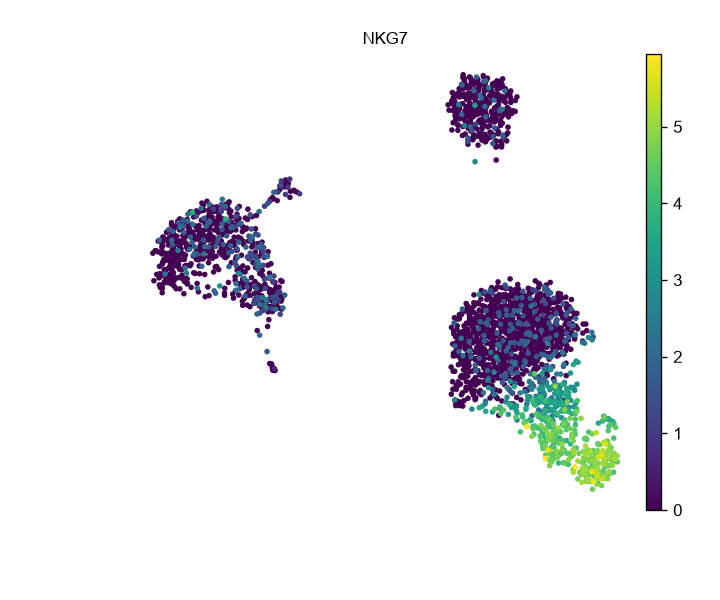
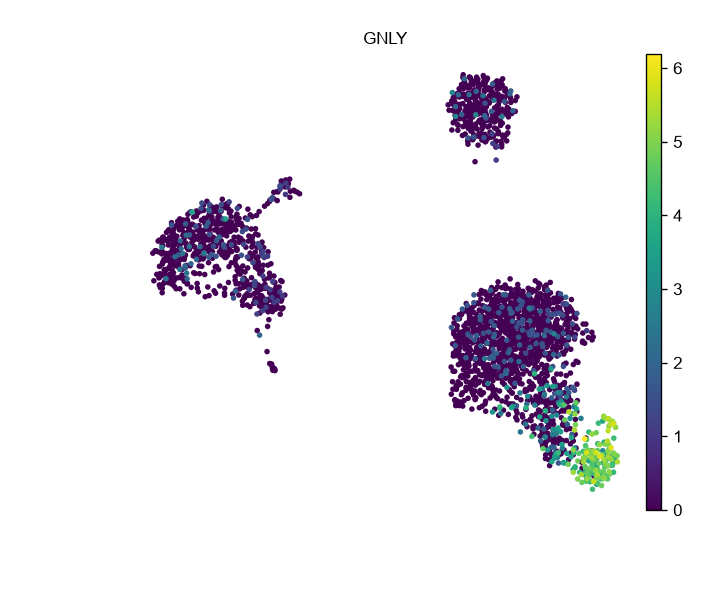
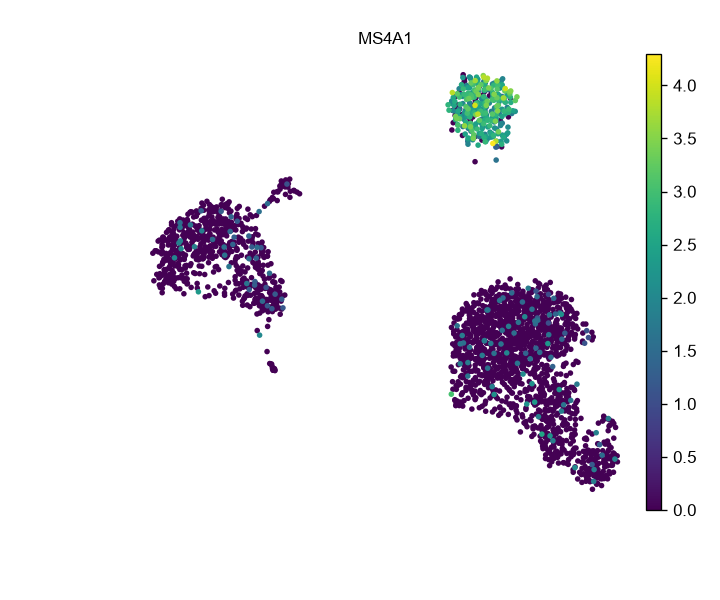
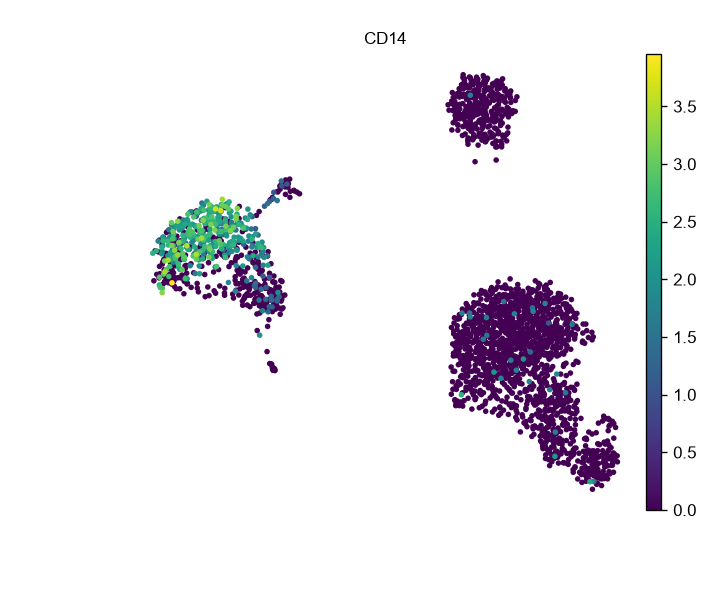
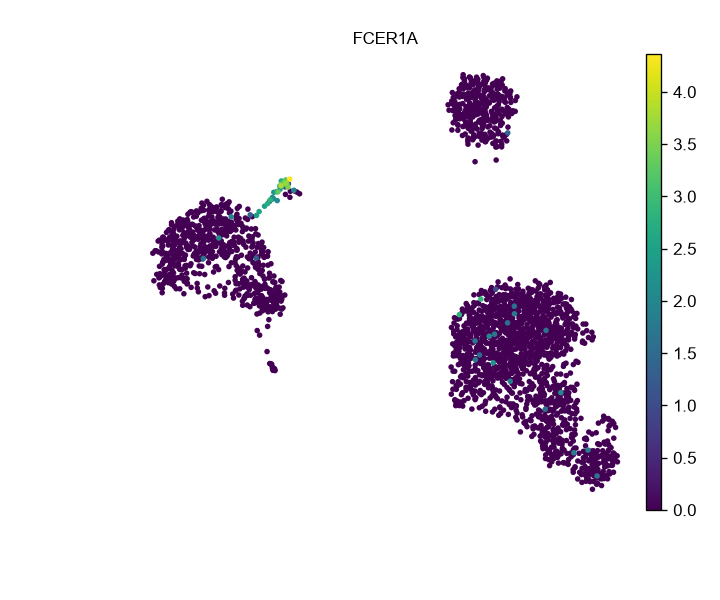
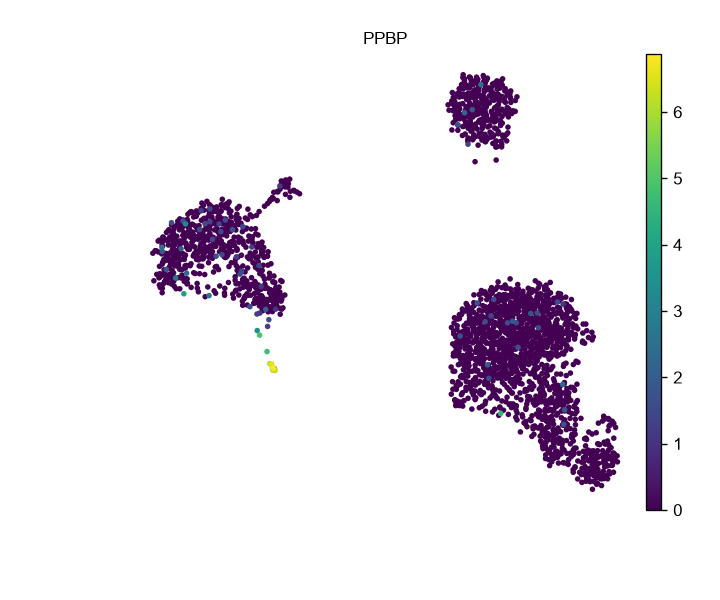
根据各簇的经典 Marker 表达,将细胞归并为 CD4 T、NK、B、Monocyte、DC 和 Platelet 六类主要细胞。注释同时参考聚类点图、细胞类型点图和 Marker 表达分布。
#关键 Marker 的空间验证
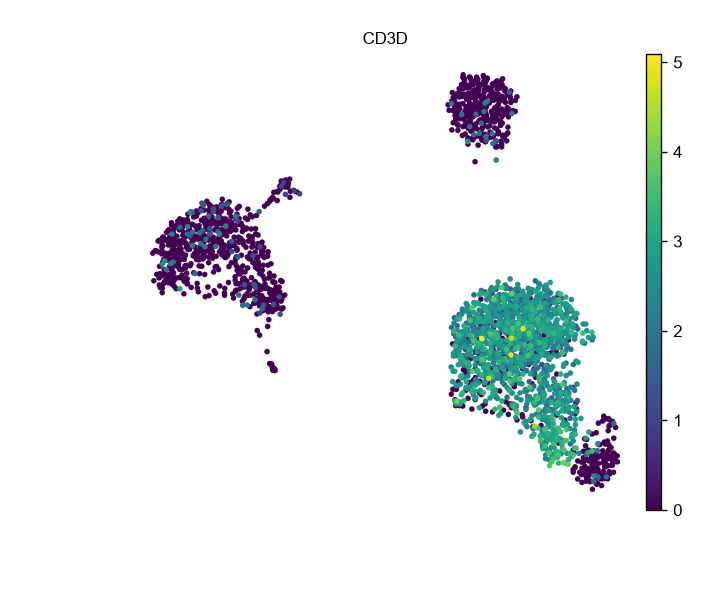
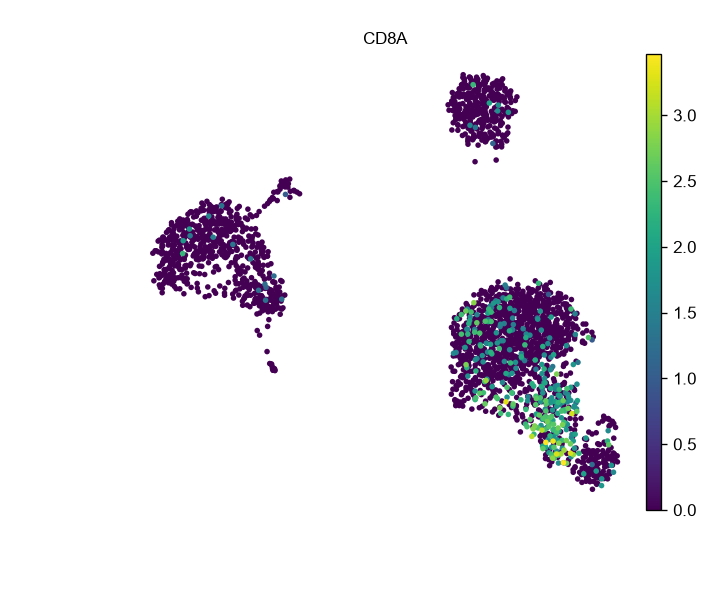
单基因 UMAP 可直观看到 Marker 在转录空间中的定位。Marker 信号与对应细胞群重合,进一步支持注释结果。
#细胞类型组成
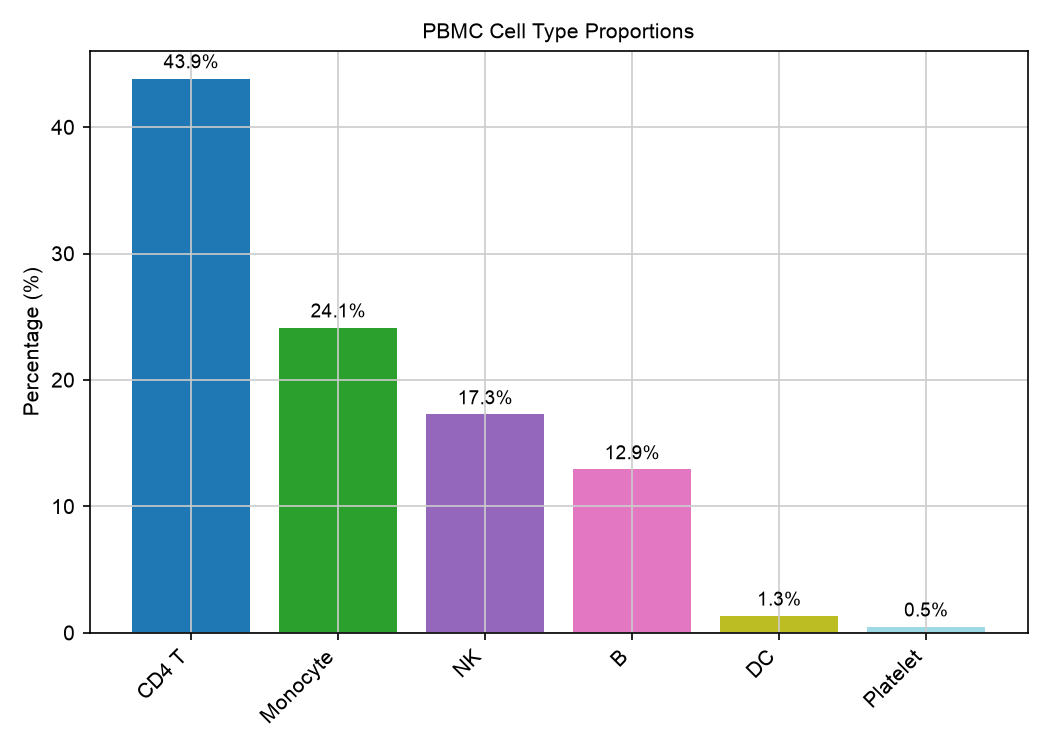
CD4 T 细胞数量最多,占 43.85%;单核细胞占 24.14%;NK 细胞占 17.27%;B 细胞占 12.92%;DC 和 Platelet 分别占 1.34% 和 0.48%。
| 细胞类型 | 细胞数 | 占比 |
|---|---|---|
| CD4 T | 1,181 | 43.85% |
| Monocyte | 650 | 24.14% |
| NK | 465 | 17.27% |
| B | 348 | 12.92% |
| DC | 36 | 1.34% |
| Platelet | 13 | 0.48% |
#结果文件
results/ANALYSIS_REPORT.md:完整分析报告results/pbmc_immune_atlas.h5ad:包含表达矩阵、PCA、UMAP、聚类和注释的 AnnData 对象results/cell_type_proportions.csv:细胞类型数量与比例results/figures:质量控制、聚类、注释和 Marker 图件scripts/pbmc_immune_atlas.py:可复现分析脚本
#结果总结
本案例从 2,700 个原始 PBMC 中获得 2,693 个高质量细胞,并识别出 7 个 Leiden 簇和 6 类主要免疫细胞。CD4 T 细胞占比最高,其次为单核细胞、NK 细胞和 B 细胞。多种 Marker 可视化结果共同支持主要细胞类型注释,说明完整流程已成功跑通。
#使用建议
- 初次体验可直接使用推荐选项,先完成整个流程,再调整参数。
- 使用自己的数据时,应补充样本来源、物种、测序平台、分组信息和文件路径。
- 注释时不要只看单个 Marker,应同时检查多个阳性和阴性 Marker。
- 多样本整合时应增加批次校正、供体分层和注释一致性评估。
- 后续可基于
pbmc_immune_atlas.h5ad开展亚群细分和差异表达分析。