单细胞细胞类型注释:Marker 与自动注释
细胞类型注释是给聚类得到的细胞群或单个细胞赋予生物学身份,例如 CD4 T 细胞、经典单核细胞、成纤维细胞。主要有三种思路:一是基于 marker 基因手动注释,依据文献和数据库中的经典标志基因判断每个簇的身份;二是基于参考表达谱的自动注释,如 SingleR 用已标注的 bulk 或单细胞参考数据,按相关性给每个细胞打标签;三是基于预训练模型或参考图谱映射,如 CellTypist 用逻辑回归模型分类,Seurat 和 Azimuth 把查询数据投影到参考图谱。实际中常先自动注释给出候选,再用 marker 逐簇核对。
什么时候用
- 完成聚类后需要给每个簇命名,用于作图和后续分析
- 研究免疫细胞等有成熟参考图谱的组织,可用自动注释提速
- 大规模数据簇很多,手动逐个判断效率低
- 需要统一多个数据集的细胞类型命名,便于跨研究比较
- 怀疑某簇是罕见或未报道的细胞状态,需要多方法交叉验证
不适合的情况
- 参考数据集不含目标组织的细胞类型时,自动注释会强行给出最相近但错误的标签
- 仅凭一两个 marker 定性亚群,单个基因在不同组织中的特异性可能不同
- 肿瘤细胞的恶性与否不能靠注释判断,应结合 CNV 推断等方法
需要准备的数据
- 聚类后的单细胞对象
- 含归一化表达、聚类标签和 UMAP 坐标的 Seurat 对象或 h5ad 文件
- 归一化表达矩阵
- CellTypist 要求每个细胞归一化到 10000 总计数并取 log1p;SingleR 使用对数归一化表达
- 参考数据集或模型
- 如 celldex 中的参考集、CellTypist 预训练模型、组织对应的已注释单细胞图谱
- marker 基因清单
- 来自文献或 CellMarker、PanglaoDB 等数据库,按物种和组织整理,基因名与数据一致
分析步骤
- 1
确定注释粒度
先决定标签层级,如先标注 T、B、髓系等大类,再在大类内注释亚群。分层注释可减少大类间的混淆,也便于后续针对某一大类子集再聚类。
- 2
找每个簇的 marker
用 Seurat 的 FindAllMarkers 或 Scanpy 的 rank_genes_groups 找各簇上调基因,优先看表达比例和倍数变化都高的基因,排除线粒体和核糖体基因。主要簇都应有能对应已知类型的 marker。
- 3
运行自动注释
SingleR 以参考集表达谱逐个细胞打分,可按簇聚合后注释以提高稳定性;CellTypist 选择匹配组织的模型,可开启 majority_voting 按过聚类结果投票。保存每个细胞的得分或概率,供后续筛查低置信度细胞。
- 4
参考图谱映射
有高质量同组织参考图谱时,可用 Seurat 的 FindTransferAnchors 和 MapQuery 或 Azimuth 把数据投影到参考空间并转移标签。映射后查看预测得分,得分低的细胞可能是参考中缺失的类型。
- 5
marker 逐簇核对
用点图展示每个候选类型的经典 marker,如 CD3E、MS4A1、CD14、NKG7、PPBP。自动注释标签与 marker 一致的簇直接采用;不一致的簇以 marker 为主,并查看它在两种方法中的得分分布。
- 6
处理未知与可疑簇
得分普遍低或 marker 混杂的簇,先排查是否为残留双细胞或低质量细胞;排除后仍无法对应已知类型的,标为待定并单独分析其 marker,不要强行套用参考标签。
- 7
整理最终标签
把确定的标签写入元数据,统一命名规则和大小写。输出带标签的 UMAP、marker 点图和每类细胞数统计,并在方法中注明所用参考集或模型及版本。
关键参数与决策
参考数据集选择
参考应与查询数据的物种、组织和测序技术接近。celldex 的 HumanPrimaryCellAtlasData 覆盖广但粒度粗,MonacoImmuneData 更适合免疫细胞细分。参考缺少目标类型时,算法无法给出正确标签。
逐细胞还是逐簇注释
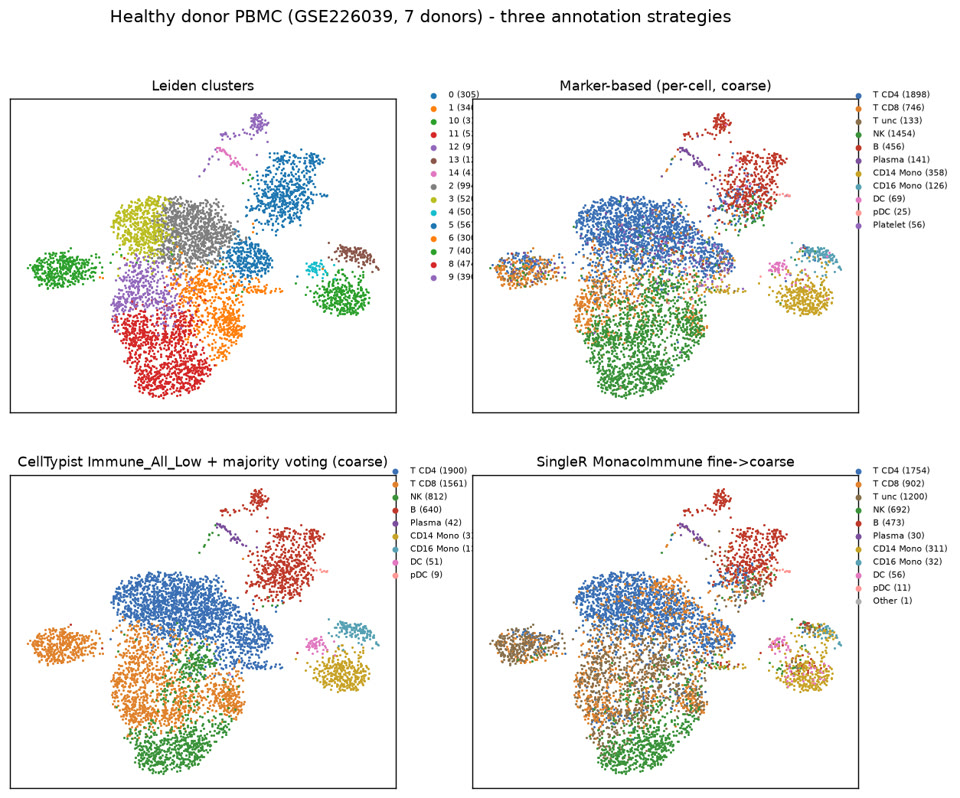
逐细胞注释能发现簇内混杂,但噪音大;逐簇注释更稳定,却会掩盖簇内异质性。常用做法是两者都做,以逐簇结果为主,用逐细胞结果检查簇是否需要拆分。
CellTypist 模型与 majority_voting
模型按组织和粒度区分,如免疫细胞有高、低两个粒度的模型。开启 majority_voting 后,会在过聚类的小群内取多数标签,结果更平滑,但可能抹掉少量稀有细胞。
低置信度过滤
SingleR 提供 pruned.labels,会把得分差异过小的细胞标为 NA;CellTypist 输出每类概率。可按得分或概率设阈值,把低置信度细胞标为未确定,而不是全部接受最高分标签。
常见错误
- 用免疫细胞参考集注释实体瘤组织:上皮、成纤维、内皮等细胞会被强行标成最相近的免疫类型,造成整类细胞注释错误。
- 只看自动注释结果不核对 marker:参考集和查询数据的批次差异会让部分簇的标签系统性偏移,审稿人常要求提供 marker 证据。
- 把一个 marker 当作唯一依据:如 CD4 在人单核细胞上也有表达,FOXP3 在少量活化 T 细胞中也会出现,应使用一组 marker 综合判断。
- 基因命名不一致:小鼠数据配人类参考、Ensembl ID 配基因符号,都会导致大量基因无法匹配,自动注释结果几乎随机。
- 未先去除双细胞就注释:双细胞簇会同时匹配两类标签,被误命名为新的过渡态或混合细胞群。
- 参考映射得分低的细胞被直接赋予最高分标签:这些往往是参考中不存在的细胞类型,应单独标记并分析。
结果怎么看
注释后的 UMAP
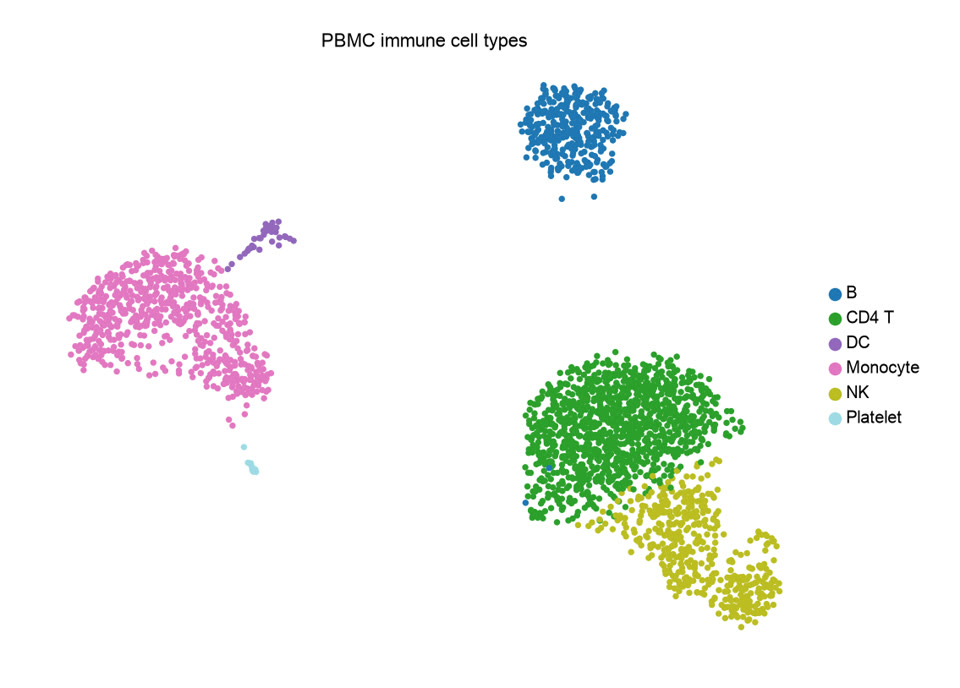
按最终细胞类型着色。同一类型应形成连贯区域,相邻类型在生物学上通常相关,如各 T 细胞亚群靠近。某一类型被分散在多个远离的区域时,检查是否混入了不同来源的细胞或标签有误。
marker 点图
行为细胞类型,列为经典 marker,点大小为表达比例,颜色为平均表达。理想情况下呈对角块状;某类型在多组 marker 上都有中等表达,提示它可能是双细胞或注释粒度不够。
SingleR 得分热图
plotScoreHeatmap 展示每个细胞与各参考标签的相关得分。最高分明显高于次高分的细胞注释可靠;多个标签得分接近的细胞,说明参考集无法区分它们,应结合 marker 判断。
多方法一致性表
对比 SingleR、CellTypist 与 marker 手动注释的标签交叉表。大部分细胞应落在对角线上;集中出现在非对角的簇需重点复核,通常是参考粒度或命名体系不同造成的。
和相近方法怎么选
Marker 手动注释与自动注释
手动注释可解释性强,能处理参考中没有的细胞类型,但耗时且依赖经验。自动注释速度快、可复现,但受参考集限制。推荐用自动注释给候选标签,再用 marker 逐簇确认,最终结论以 marker 证据为准。
SingleR 与 CellTypist
SingleR 是 R 包,按与参考表达谱的相关性打分,可用任意 bulk 或单细胞参考。CellTypist 是 Python 工具,用预训练逻辑回归模型,免疫模型完善、速度快。有匹配模型时用 CellTypist 方便,需自定义参考时 SingleR 更灵活。
标签转移与参考图谱映射
SingleR、CellTypist 只给出标签;Seurat 参考映射、Azimuth 或 scArches 还会把查询细胞投影到参考的低维空间,便于在统一坐标中比较。映射更依赖参考质量,参考与查询批次差异大时需谨慎解读。
常见问题
单细胞注释用 SingleR 还是 CellTypist?
看组织和参考资源。免疫细胞数据可直接用 CellTypist 的免疫模型;其他组织有合适 bulk 或单细胞参考时,用 SingleR 更灵活。两者可同时运行,结果一致的簇可信度更高,不一致的再用 marker 判断。
自动注释和 marker 判断冲突时听谁的?
通常以 marker 为准,但要检查 marker 选得是否合适。冲突常来自参考集缺少该细胞类型、参考粒度过粗或命名体系不同。可查看该簇的自动注释得分,若最高分也不高,说明参考本身不适用。
常用的人类免疫细胞 marker 有哪些?
常用的有:T 细胞 CD3E、CD3D,B 细胞 MS4A1、CD79A,NK 细胞 NKG7、GNLY,经典单核细胞 CD14、LYZ,非经典单核细胞 FCGR3A,树突状细胞 FCER1A,血小板 PPBP,浆细胞 MZB1、JCHAIN。具体组织中应结合文献调整。
找不到对应细胞类型的簇怎么命名?
先排除双细胞、低质量细胞和应激细胞。确认是高质量细胞后,可按其 top marker 命名,如某基因高表达的成纤维细胞亚群,并在文中说明依据。不建议强行套用已知类型名称。
小鼠数据可以用人类参考注释吗?
不建议直接用。需先做同源基因转换,且跨物种表达差异会降低准确性。优先选择小鼠参考,如 celldex 中的小鼠参考集或已发表的小鼠组织图谱。
在 Codar 里怎么做
在 Codar 里说明物种、组织和已有聚类结果后,会先确认参考集或模型以及注释粒度。随后进行单细胞类型注释与参考映射:用参考数据或预训练模型给细胞打标签,结合 marker 逐簇核对,标出低置信度细胞群。交付注释 UMAP、marker 点图、注释得分图、多方法一致性表、细胞数统计、带标签的数据对象和可复现脚本。
我的 PBMC 单细胞数据已聚成 12 个簇,帮我用 SingleR 和 CellTypist 注释,再用经典 marker 核对,冲突的簇单独列出