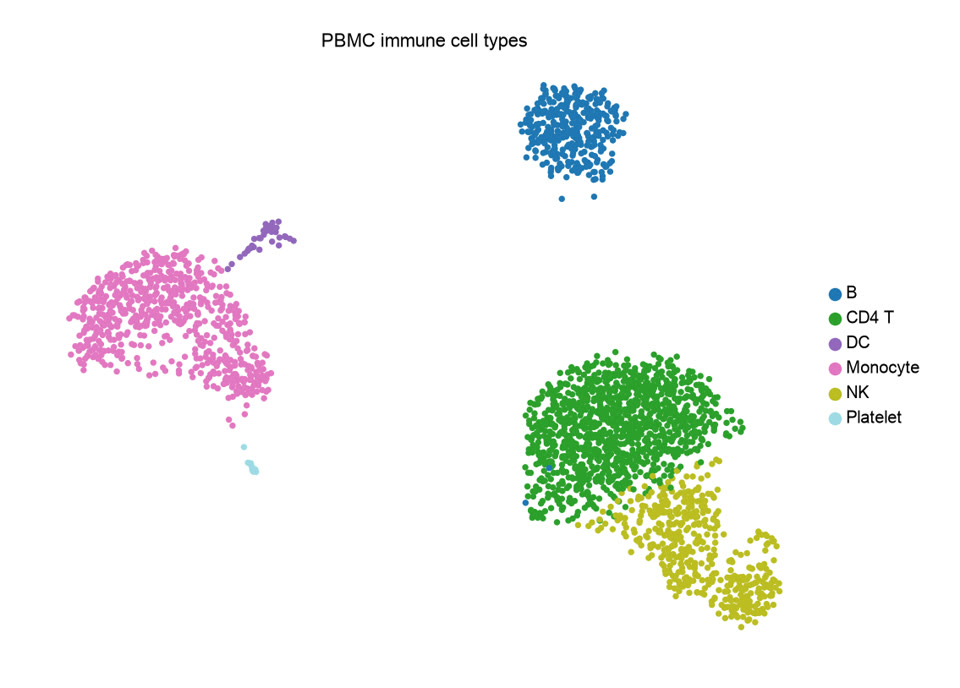
单细胞降维与聚类:PCA、UMAP 与 Leiden
单细胞降维与聚类是把数千到数十万个细胞按表达相似性分成若干群,为后续细胞类型注释、差异分析和比例比较提供分组基础。标准流程是:对质控后的计数做归一化和对数转换,筛选高变基因,做 PCA 压缩到几十个主成分,在主成分空间构建 K 近邻图,用 Leiden 或 Louvain 社区检测算法切分细胞群,最后用 UMAP 或 t-SNE 把高维结构投影到二维展示。Seurat 和 Scanpy 都实现了这套流程。需要注意,聚类结果依赖多个参数,簇的数量没有唯一正确答案,它应与研究问题所需的细胞类型粒度匹配。
什么时候用
- 完成质控后,需要把细胞分群以便做细胞类型注释
- 想发现已知细胞类型内部的亚群,如 T 细胞耗竭亚群
- 比较不同分辨率下细胞群的拆分关系,确定合适粒度
- 为差异表达、细胞通讯、轨迹分析准备细胞分组
- 在整合后的多样本数据上重新分群,检查批次是否混匀
不适合的情况
- 用 UMAP 上簇之间的距离判断细胞类型亲缘关系,UMAP 不保真全局距离
- 多样本存在明显批次效应时直接聚类,会出现按样本而非细胞类型分开的簇
- 把聚类数当作细胞类型数,过度聚类会把同一类型按状态或质量拆开
需要准备的数据
- 质控后计数矩阵
- 已去除低质量细胞和双细胞的原始 UMI 计数,保存为 Seurat 对象、h5ad 或 10x 矩阵
- 细胞元数据
- 样本、分组、批次、质控指标等列,用于检查簇是否由技术因素驱动
- 整合后嵌入(可选)
- 多样本数据若已做 Harmony 或 scVI 整合,用整合后的低维嵌入代替 PCA 构图
分析步骤
- 1
归一化与对数化
常用做法是把每个细胞缩放到相同总计数后取 log1p,Scanpy 用 normalize_total 和 log1p,Seurat 用 NormalizeData;也可用 SCTransform 完成归一化和方差稳定。原始计数要另存一层供差异分析使用。
- 2
筛选高变基因
选出细胞间变异最大的基因作为降维输入,常用 2000 个左右。多样本时建议按批次分别计算再合并,避免批次特异基因被选入。判断标准:高变基因列表中应有已知 marker,而不是以线粒体或核糖体基因为主。
- 3
缩放与 PCA
对高变基因做标准化缩放后运行 PCA。可在缩放时回归掉总 UMI 数或线粒体比例,但不要随意回归生物学变量。查看前几个主成分的载荷基因,确认它们对应细胞类型差异,而不是应激基因或质控指标。
- 4
选择主成分数
看肘部图中方差解释比例的拐点,或比较不同主成分数下的聚类稳定性。常见取值在 10 到 50 之间,细胞类型复杂的数据取多一些。少量多取通常比少取安全,少取会把稀有群体的信号丢掉。
- 5
构建近邻图并聚类
在选定主成分上计算 K 近邻图,再运行 Leiden 聚类,Scanpy 用 neighbors 和 leiden,Seurat 用 FindNeighbors 和 FindClusters。同时跑多个分辨率,用 clustree 观察簇随分辨率如何分裂。
- 6
UMAP 可视化
基于同一近邻图或主成分计算 UMAP。按簇、样本、质控指标分别着色:簇在 UMAP 上应相对连贯;某簇若只来自一个样本或线粒体比例显著偏高,需回头检查质控和批次。
- 7
评估与确定粒度
为每个簇找 marker 基因,检查相邻簇的 marker 是否有实质差异。两个簇没有特异 marker 时可合并;一个簇内 marker 明显分成两组时可提高分辨率或对该簇单独再聚类。
关键参数与决策
Leiden 分辨率
分辨率越高簇越多,Scanpy leiden 默认 1.0,Seurat FindClusters 默认 0.8。没有最优值:大类注释用较低分辨率,找亚群时对目标大类子集再聚类,而不是全局拉高分辨率。
主成分数
决定多少变异信息进入构图。取太少会丢失稀有细胞群的区分信号,太多会引入噪音但影响通常较小。建议结合肘部图和不同取值下聚类结果的稳定性选择,并在方法中写明。
近邻数 K
影响图的局部与全局平衡,Scanpy neighbors 默认 15,Seurat FindNeighbors 默认 20。K 小更易分出小群体但噪音大,K 大结构更平滑,稀有细胞可能被并入大群。
高变基因数量
常用 2000 左右,异质性高的组织可增加到 3000 到 5000。数量太少会漏掉亚群 marker,太多会纳入大量低信息基因,稀释主成分中的生物信号。
UMAP 的 min_dist
控制点在二维图上的聚拢程度,值小簇更紧凑、边界更清楚,值大分布更均匀。它只影响可视化,不改变聚类结果,调参时不要因为图好看而误判簇的数量。
常见错误
- 根据 UMAP 图形状决定簇数:UMAP 只是可视化,两个视觉上分开的团可能同属一簇,视觉上连在一起的也可能是不同类型。
- 全局把分辨率拉得很高来找亚群:大量簇是按细胞周期、质量或随机噪音切分的,注释时难以解释,且结果对参数非常敏感。
- 用归一化后但未缩放的矩阵做 PCA:高表达基因主导主成分,低表达但有区分度的转录因子信号被掩盖。
- 在缩放时回归掉分组变量:会把要研究的处理效应一并去除,后面再比较组间差异时信号已经被削弱。
- 多样本数据未检查簇的样本组成:某簇几乎全部来自一个样本时,常是批次效应而非新细胞类型,应先做整合再聚类。
- 把 UMAP 坐标距离当作发育关系的证据:UMAP 保留局部邻近关系,不保证簇间距离有意义,轨迹推断应使用专门方法。
结果怎么看
PCA 肘部图
横轴为主成分序号,纵轴为方差解释比例或标准差。曲线在某处明显变平,即可作为主成分数参考。若前几个主成分方差极高,检查其载荷基因是否是线粒体或应激基因,若是,说明质控需要加强。
分辨率聚类树
clustree 图展示簇随分辨率增加如何分裂。稳定的簇在多个分辨率下保持不变;频繁在不同簇之间来回交叉分配的细胞群说明边界不清,选在这些分辨率上的结果可靠性较低。
UMAP 按簇和样本着色
按簇着色看分群是否连贯,按样本着色看各簇是否由多个样本共同构成。正常情况下主要细胞类型应包含所有样本的细胞;某个簇只出现在一个样本中,需区分是样本特有生物学还是批次效应。
簇 marker 点图与热图
点图中点大小表示表达细胞比例,颜色表示平均表达。每个簇应有一组较特异的 marker;某簇的 top marker 是线粒体、核糖体或热休克基因,通常是低质量或应激细胞,需复核质控。
和相近方法怎么选
Leiden 与 Louvain
两者都是基于模块度的图社区检测算法。Leiden 是 Louvain 的改进版,能保证社区内部连通,避免 Louvain 偶发的断裂社区。Scanpy 推荐 Leiden;Seurat 默认用 Louvain,可通过 algorithm 参数改用 Leiden。
UMAP 与 t-SNE
两者都用于二维可视化。UMAP 通常运行更快,对全局结构的保留略好;t-SNE 更强调局部邻近关系,簇间距离几乎没有意义。两者都不应作为定量分析依据,选择主要看领域惯例和图的可读性。
全局聚类与子集再聚类
全局聚类适合划分大类细胞。要研究某一大类内部的亚群,常用做法是取出该子集,重新筛选高变基因、做 PCA 和聚类,因为子集内部的变异主轴与全局不同,亚群信号能更清楚地显现。
常见问题
单细胞聚类分辨率怎么选?
按研究需要的粒度选。先用多个分辨率聚类,在聚类树中找簇划分稳定的区间,再看每个簇是否有可解释的特异 marker。做大类注释时选择较低分辨率,研究亚群时对目标细胞子集再聚类,不要只为增加簇数而拉高分辨率。
PCA 应该取多少个主成分?
看肘部图拐点,并比较几个候选值下聚类结果是否稳定。常见范围在 10 到 50 之间,复杂组织或大数据集取多一些。宁可稍多不要过少,过少会丢失区分稀有细胞类型的主成分。
UMAP 上两个簇离得很近,说明它们关系近吗?
不一定。UMAP 主要保留局部邻近关系,簇间距离和簇的大小都会受参数影响,换个随机种子或 min_dist 布局就会变化。判断细胞类型间关系应看 marker 基因、表达相关性或用轨迹分析方法。
Seurat 和 Scanpy 的聚类结果为什么不一样?
默认参数不同,包括归一化方式、高变基因算法、近邻数、聚类算法和分辨率默认值等。两者结果在大类层面通常一致,细小亚群可能有差异。要对比时应把关键参数对齐,并以 marker 和生物学可解释性为准。
聚类后出现一个只有几十个细胞的小簇怎么办?
先看它的 marker:如果是两类细胞 marker 混合,可能是残留双细胞;如果是线粒体或应激基因,多为低质量细胞;如果有清楚的特异 marker,如血小板或浆细胞 marker,则可能是真实的稀有细胞类型,应保留。
在 Codar 里怎么做
在 Codar 里说明数据位置和想要的分群粒度后,会先确认方案,包括归一化方式、高变基因数、主成分数和分辨率范围。随后完成单细胞降维与聚类:高变基因筛选、PCA、近邻图、多分辨率 Leiden 聚类和 UMAP。交付肘部图、分辨率比较图、按簇和样本着色的 UMAP、各簇 marker 表、带标签的数据对象和可复现脚本。
我有质控好的 PBMC 单细胞 h5ad 文件,帮我做 PCA 和 Leiden 聚类,比较分辨率 0.4 到 1.2,给出各簇 marker 和 UMAP 图